

01
技术架构
平台采用前后端分离的单体应用架构:Nginx 承载前端静态资源并把 API 请求反向代理到后端,后端是单个 Spring Boot 进程,按模块化 Maven 工程组织业务边界。所有面向用户的 AI 对话走统一 Chat 接口,以 SSE 流式返回 OpenAI 兼容分块;WebSocket 承载站内信与运维终端;模型、知识库、工作流等能力在进程内编排,不引入额外的微服务部署负担。
阅读章节01
平台采用前后端分离的单体应用架构:Nginx 承载前端静态资源并把 API 请求反向代理到后端,后端是单个 Spring Boot 进程,按模块化 Maven 工程组织业务边界。所有面向用户的 AI 对话走统一 Chat 接口,以 SSE 流式返回 OpenAI 兼容分块;WebSocket 承载站内信与运维终端;模型、知识库、工作流等能力在进程内编排,不引入额外的微服务部署负担。
阅读章节02
平台后端基于 Java 与 Spring Boot 生态构建,前端基于 Vue 3 与 Vite 构建,依赖版本在交付文档中锁定,便于在信创环境中精确复现部署。
阅读章节03
平台资源占用极低,全栈常驻内存约 700 MB,最低推荐配置即可流畅运行全部功能;生产环境按并发规模与是否本地部署大模型适当提升配置。
阅读章节04
部署遵循「必要环境先就位、可选环境按需启用」的原则:必要环境缺失会影响平台运行,可选环境只影响对应的专项能力。
阅读章节05
模型路由让应用绑定一个稳定的逻辑目标,由平台在运行时选择真正执行的物理模型。路由可以先按平台、组织或用户限定使用范围,再按有序的用户与组织规则选择候选模型,使智能体、工作流、知识加工和内容生成不再绑定某个供应商或私有化实例。
阅读章节06
决策模型把结构化选择、分类与评分作为独立模型能力。LangChat 以 TypeSafe System One 请求与响应契约统一封装供应商差异;TypeSafe 托管模型、Ollama 部署以及兼容 System One 的服务,都可以通过同一个入口供工作流决策节点调用。
阅读章节07
Responses API 为外部系统提供一套同时覆盖模型生成、状态续接、函数交接和平台事件的结构化协议。登录态应用通过 `POST /responses` 直接选择模型,无需绑定 Agent ID;已发布智能体则通过原有渠道密钥、访客隔离、限流、工具授权、安全策略和审计链路暴露 `POST /v1/responses`。两类入口在内部都汇入与传输协议无关的 ChatEvent 运行时,因此平台可以增加 Responses 协议,而不需要替换既有 Chat Completions 接口,也不会让业务模块绑定某一种流格式。
阅读章节
扫描二维码或搜索微信号,联系我们可以获取白皮书 PPT、部署实施资料与演示环境安排。
本白皮书由 LangChat Agentic 官方提供 · 联系微信:LangchainChat
01
平台采用前后端分离的单体应用架构:Nginx 承载前端静态资源并把 API 请求反向代理到后端,后端是单个 Spring Boot 进程,按模块化 Maven 工程组织业务边界。所有面向用户的 AI 对话走统一 Chat 接口,以 SSE 流式返回 OpenAI 兼容分块;WebSocket 承载站内信与运维终端;模型、知识库、工作流等能力在进程内编排,不引入额外的微服务部署负担。
系统按「垂直切分 + 水平分层」组织:前端到后端接入层走统一协议,业务、扩展与基础设施三类模块各自独立, 共同单向依赖公共基础层,依赖边界由 Maven 在编译期强制约束。
平台的四条重大链路覆盖了全部核心能力:所有 AI 对话走统一聊天链路,知识库按「入库 + 检索」两段工作, 智能问数以受控方式把自然语言变为可核验的分析,持久长任务在沙箱中执行并支持断线恢复。
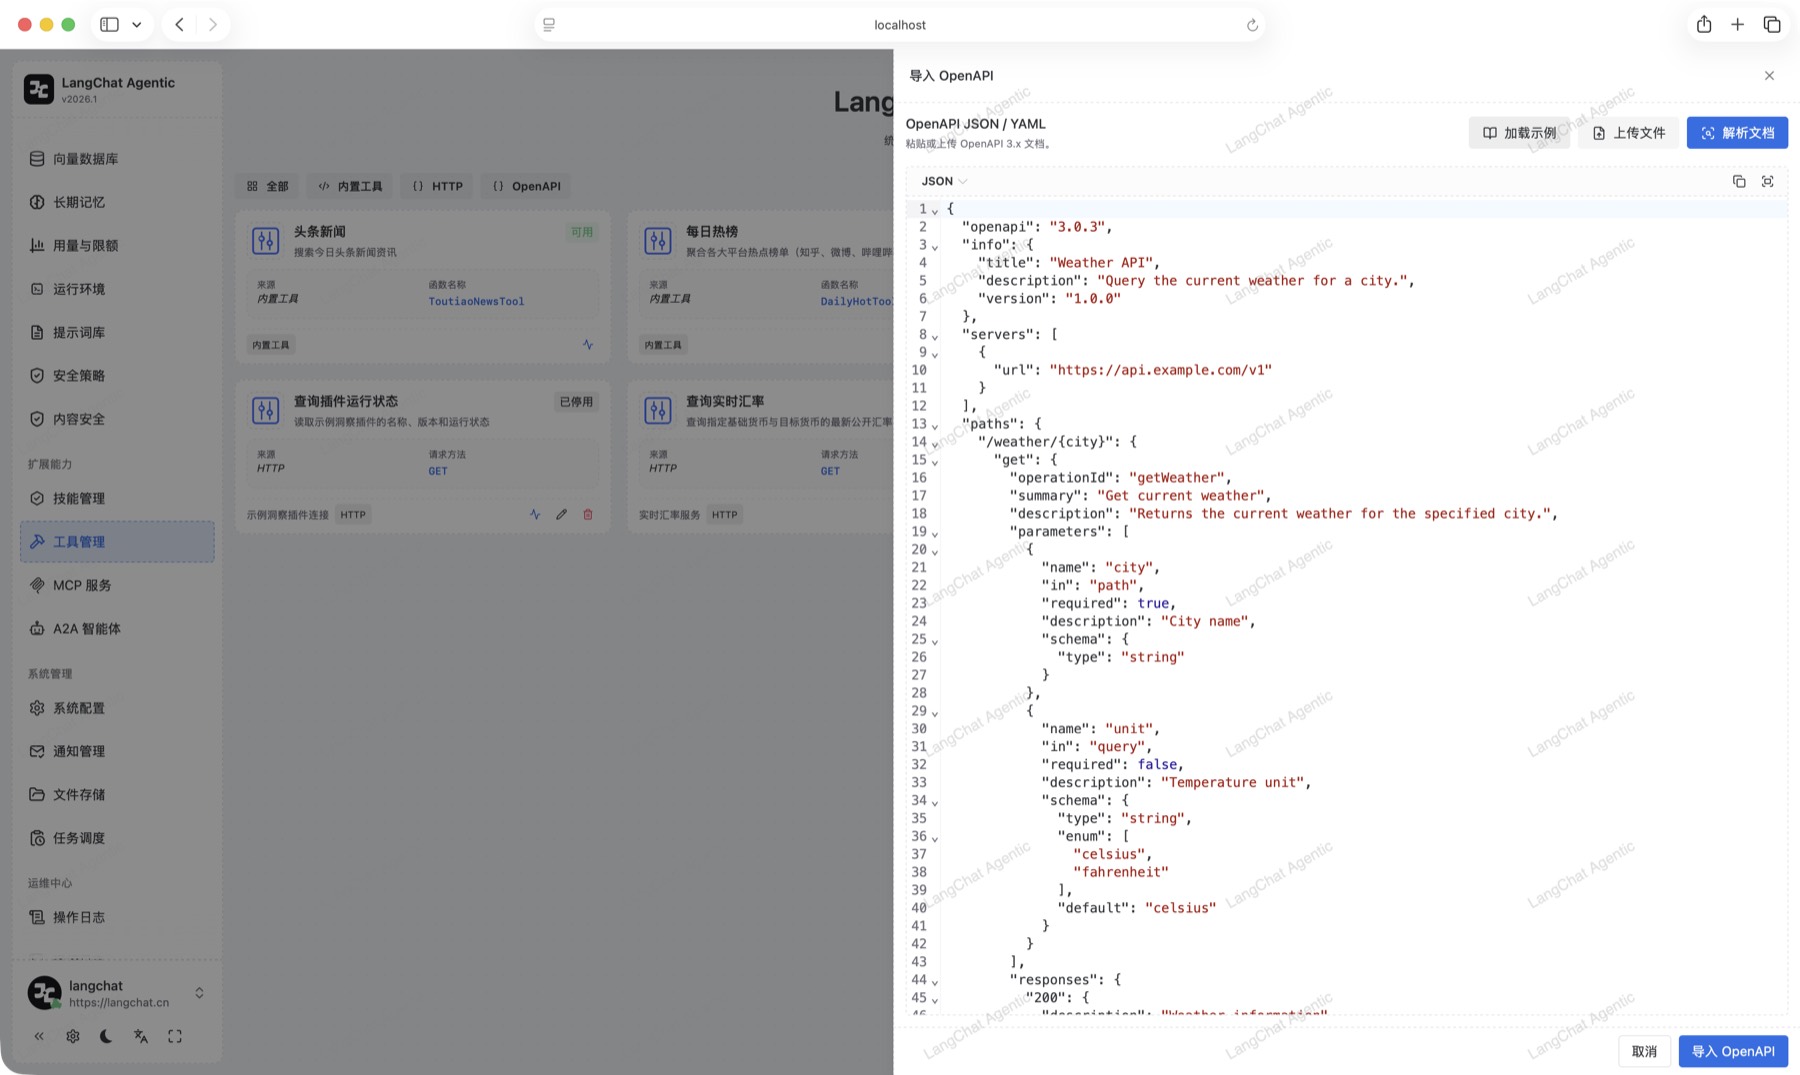
平台开放五条外部系统接入通道:模型原生 Function Call、MCP 协议、A2A 协议、Skill 技能包, 以及通过 OpenAPI 规范导入或直接注册 HTTP 接口把外部系统快速封装为 Function Call。 全部通道汇入统一工具调用运行时,由智能体、工作流与 Agentic 编排共享调用。
02
平台后端基于 Java 与 Spring Boot 生态构建,前端基于 Vue 3 与 Vite 构建,依赖版本在交付文档中锁定,便于在信创环境中精确复现部署。
后端
Java 17+(支持 21)、Spring Boot 3.5.16、MyBatis-Plus 3.5.17、Druid 1.2.28、Sa-Token 1.45.0、LangChain4j 1.18.0、MCP Java SDK 0.9.1、Apache Tika 4.0、SpringDoc OpenAPI
前端
Vue 3、TypeScript 5、Vite 5、Pinia 2、Vue Router 4、TDesign Vue Next、pnpm 10
数据与中间件
MySQL 8.0+、Redis 7+(建议 7.2)、PostgreSQL 16/17 + pgvector 0.8.0+、Nginx(任意稳定版)
必要与可选组件
必要运行环境为 OpenSandbox Server(代码执行、技能与工作区);Docling 与 MinerU(文档解析)、RustFS 与 S3 兼容对象存储、PostgreSQL + pgvector、Milvus / Elasticsearch、Ollama / vLLM / Xinference 为可选依赖,按场景启用
03
平台资源占用极低,全栈常驻内存约 700 MB,最低推荐配置即可流畅运行全部功能;生产环境按并发规模与是否本地部署大模型适当提升配置。
04
部署遵循「必要环境先就位、可选环境按需启用」的原则:必要环境缺失会影响平台运行,可选环境只影响对应的专项能力。
必要环境是平台运行的最低集合;OpenSandbox 承载代码执行、技能与工作区能力,属于平台运行环境的组成部分。可选环境按场景启用,缺失时对应能力不可用,但不影响登录、对话与智能体等基础功能。
05
应用广场集中发布和发现经过验证的智能体、工作流与 Agentic 应用,按客服、知识问答、数据分析、内容创作、办公助手和流程自动化等场景组织,业务人员可以直接在已发布应用中发起对话,无需进入编辑器。
应用广场:按场景发现已发布应用
06
智能体模块在一个入口中承载三种应用范式:标准智能体、工作流智能体和 Agentic 智能体。创建应用时先选择构建方式,再完成基础配置;不同范式适合不同复杂度和确定性要求的任务,三类应用可以相互协同调用。
创建应用:选择智能体、工作流或 Agentic 构建方式
07
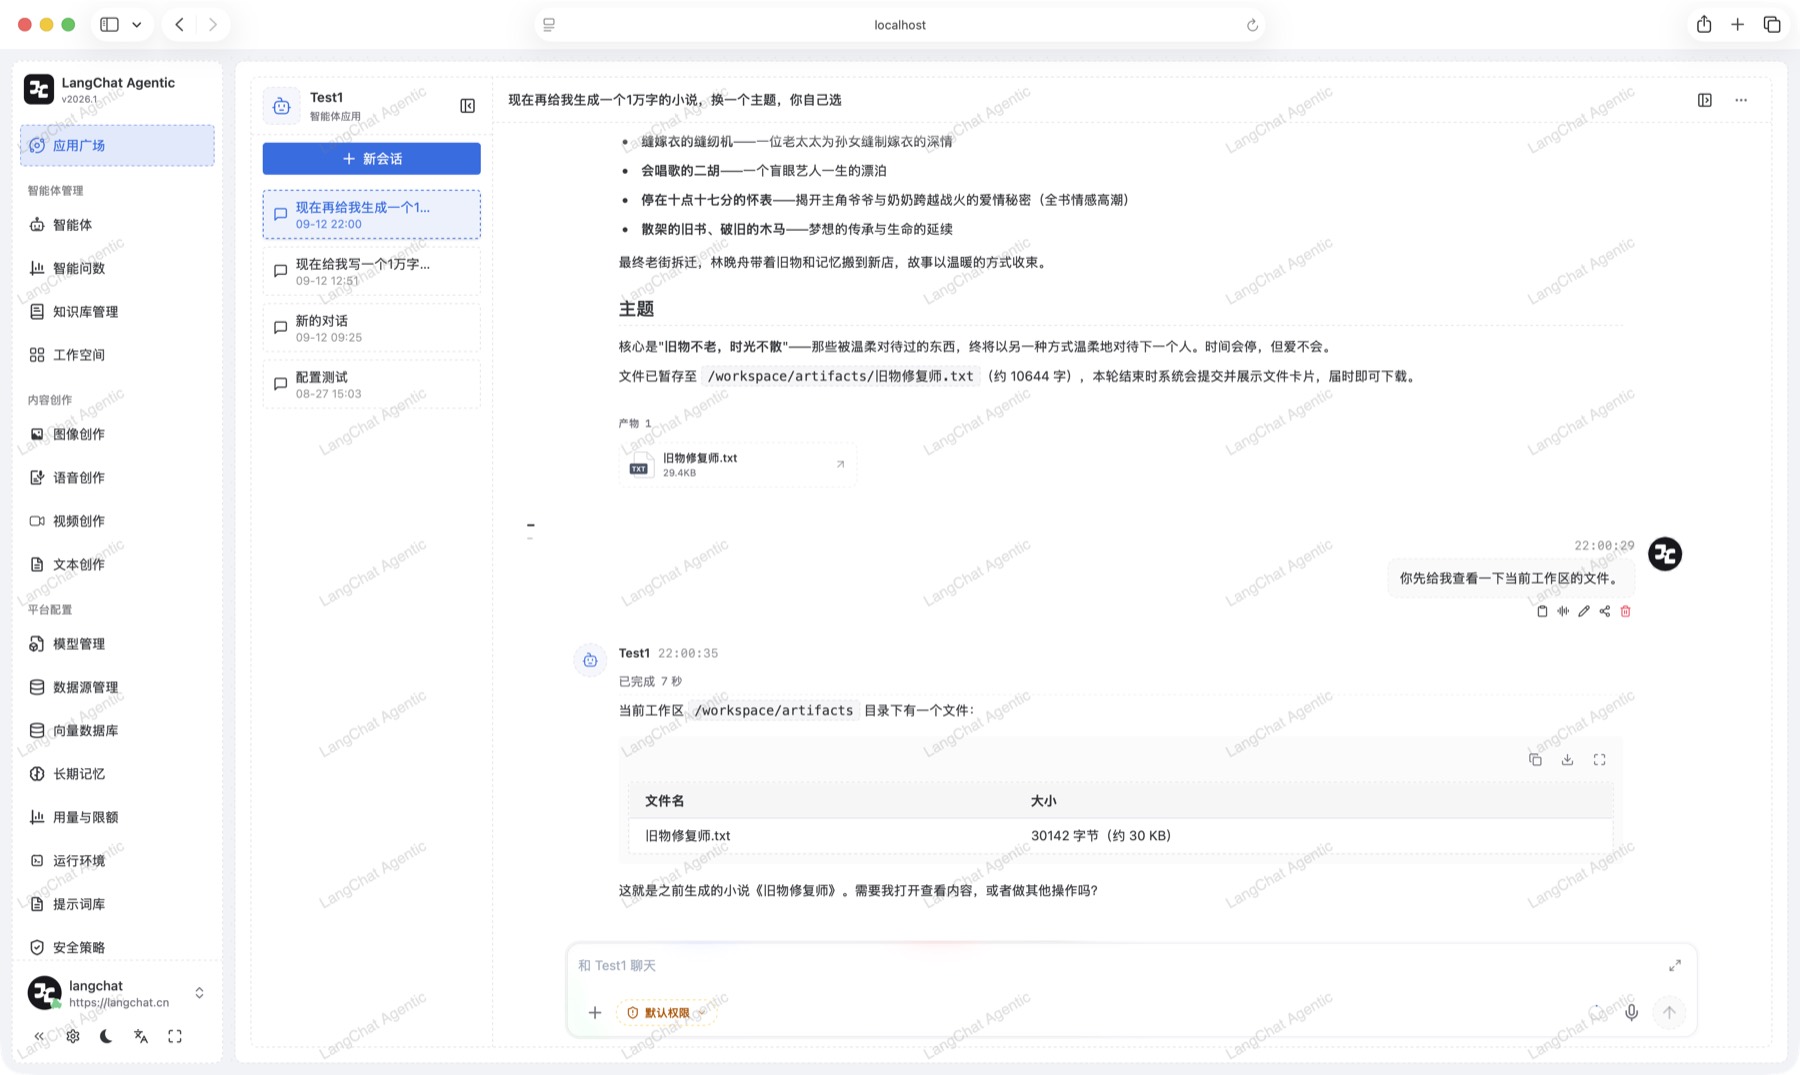
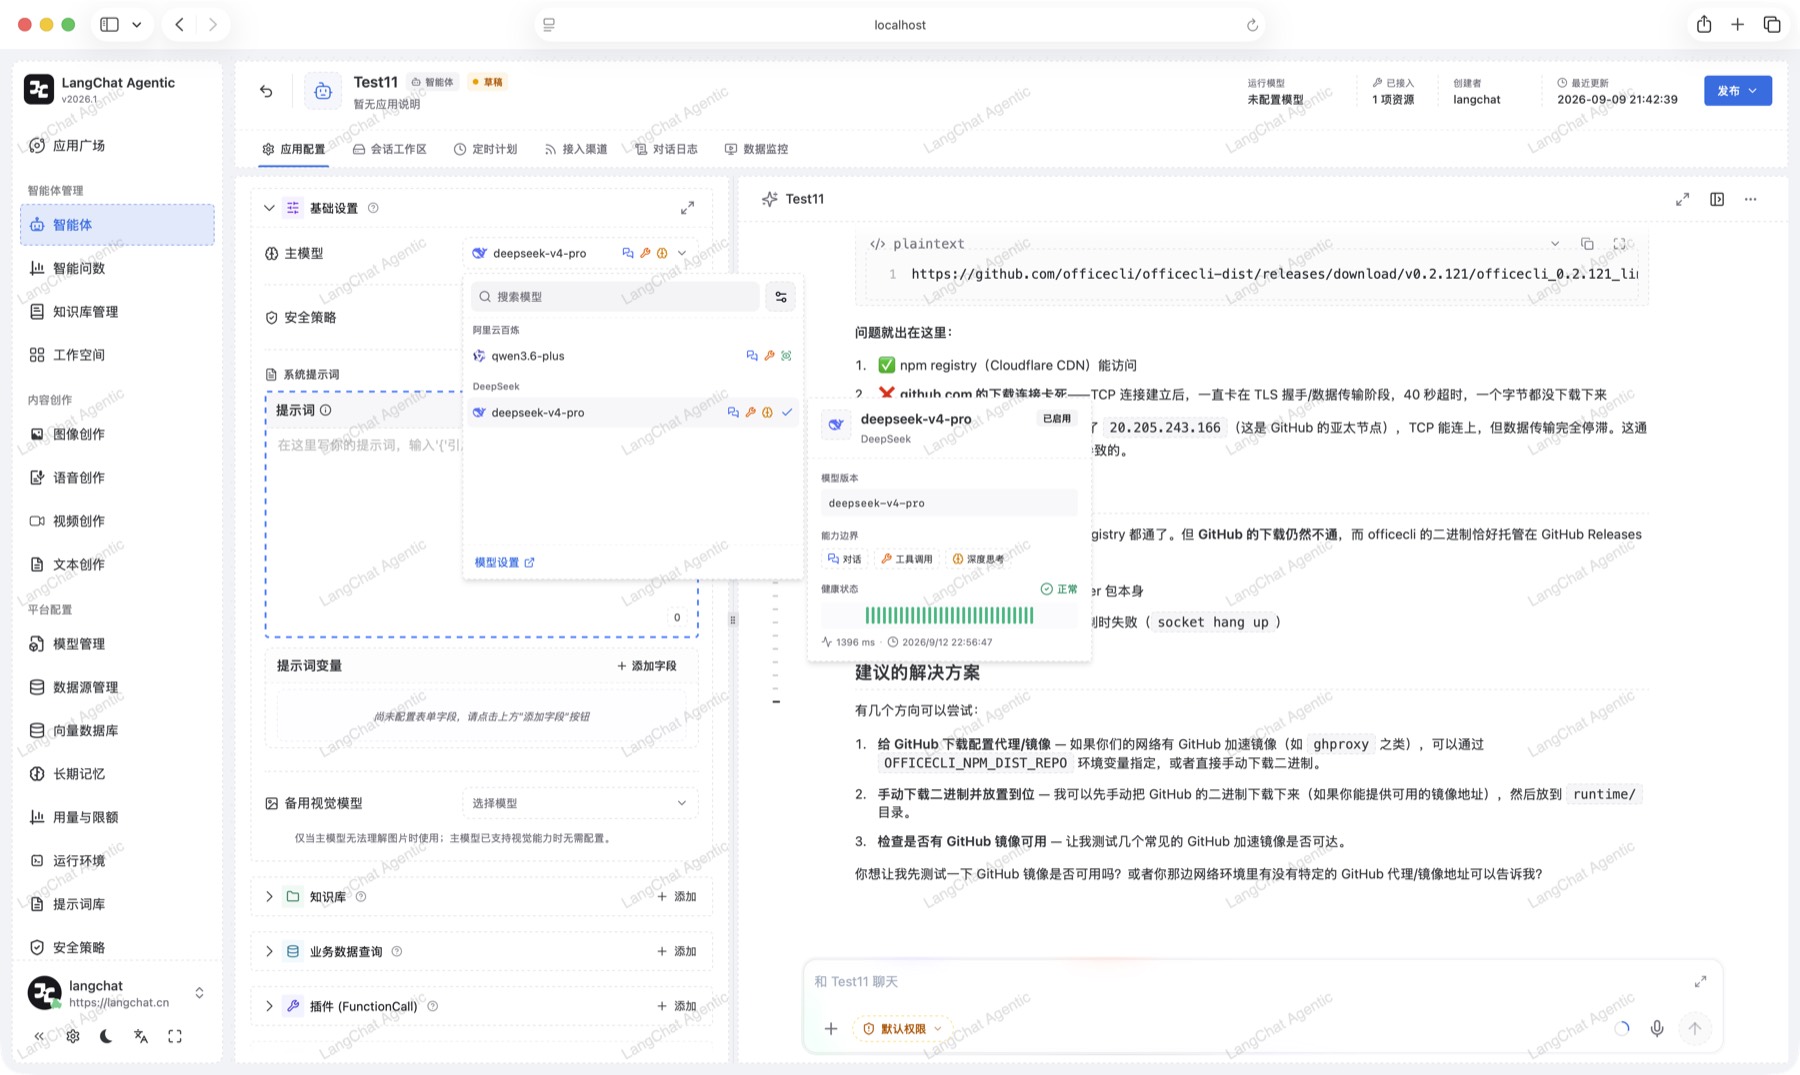
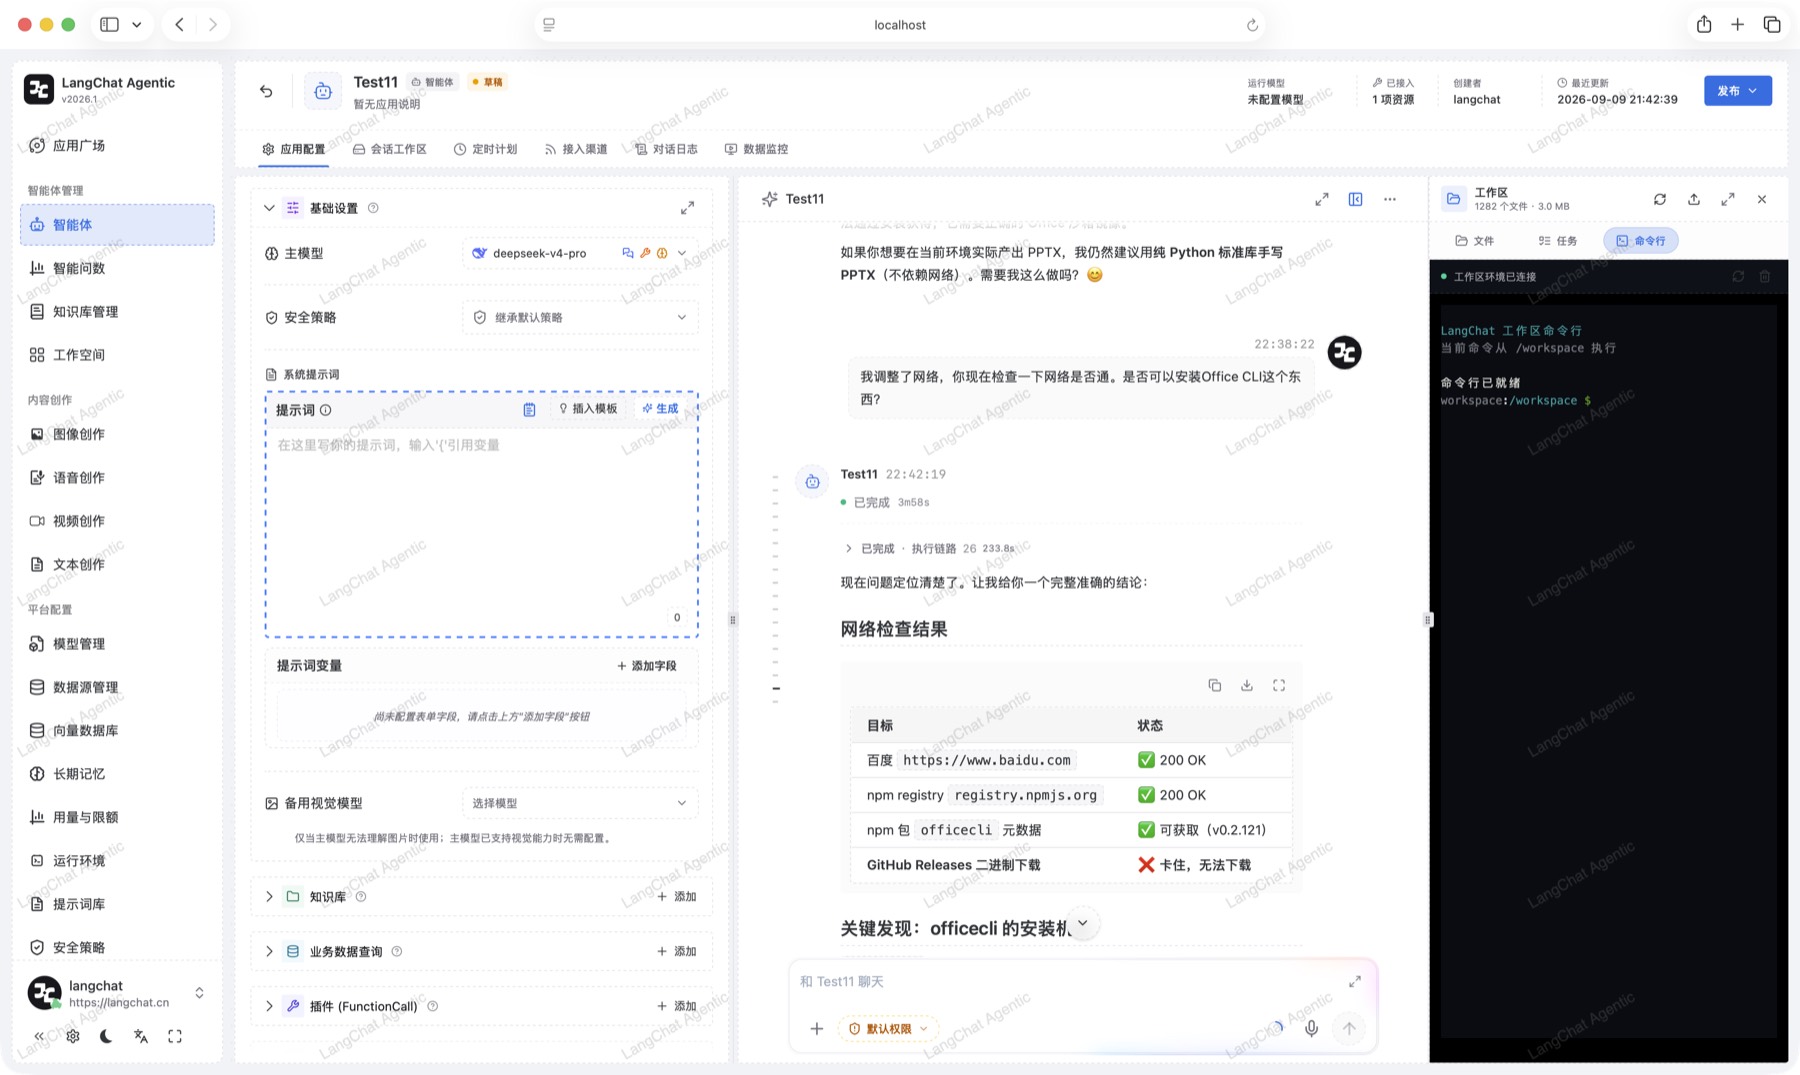
标准智能体通过主模型、系统提示词和安全策略定义服务角色,并可挂载知识库、业务数据查询、插件、技能与外部服务。模型通过动态插件注册自动调用工具完成与外部系统的交互,在会话区即可验证回答、工具调用和工作区产物。
标准智能体会话:验证回答与工作区文件
08
工作流模式通过有序的可视化流程设计,让应用按固定顺序执行,并提供自由度很高的节点,支持循环、IF 判断、意图路由、决策模型路由、大语言模型、调用应用、知识库检索、数据库查询、文档解析、图片生成、文本转语音等节点,便于定制化业务场景。
09
Agentic 模式通过挂载多个大模型或多个智能体应用,由主管智能体协同规划不同成员之间的交互,并在运行规则与应用数据契约的约束下完成任务分解、成员调度与结果评估,适合路径不固定的探索性和复杂任务。
10
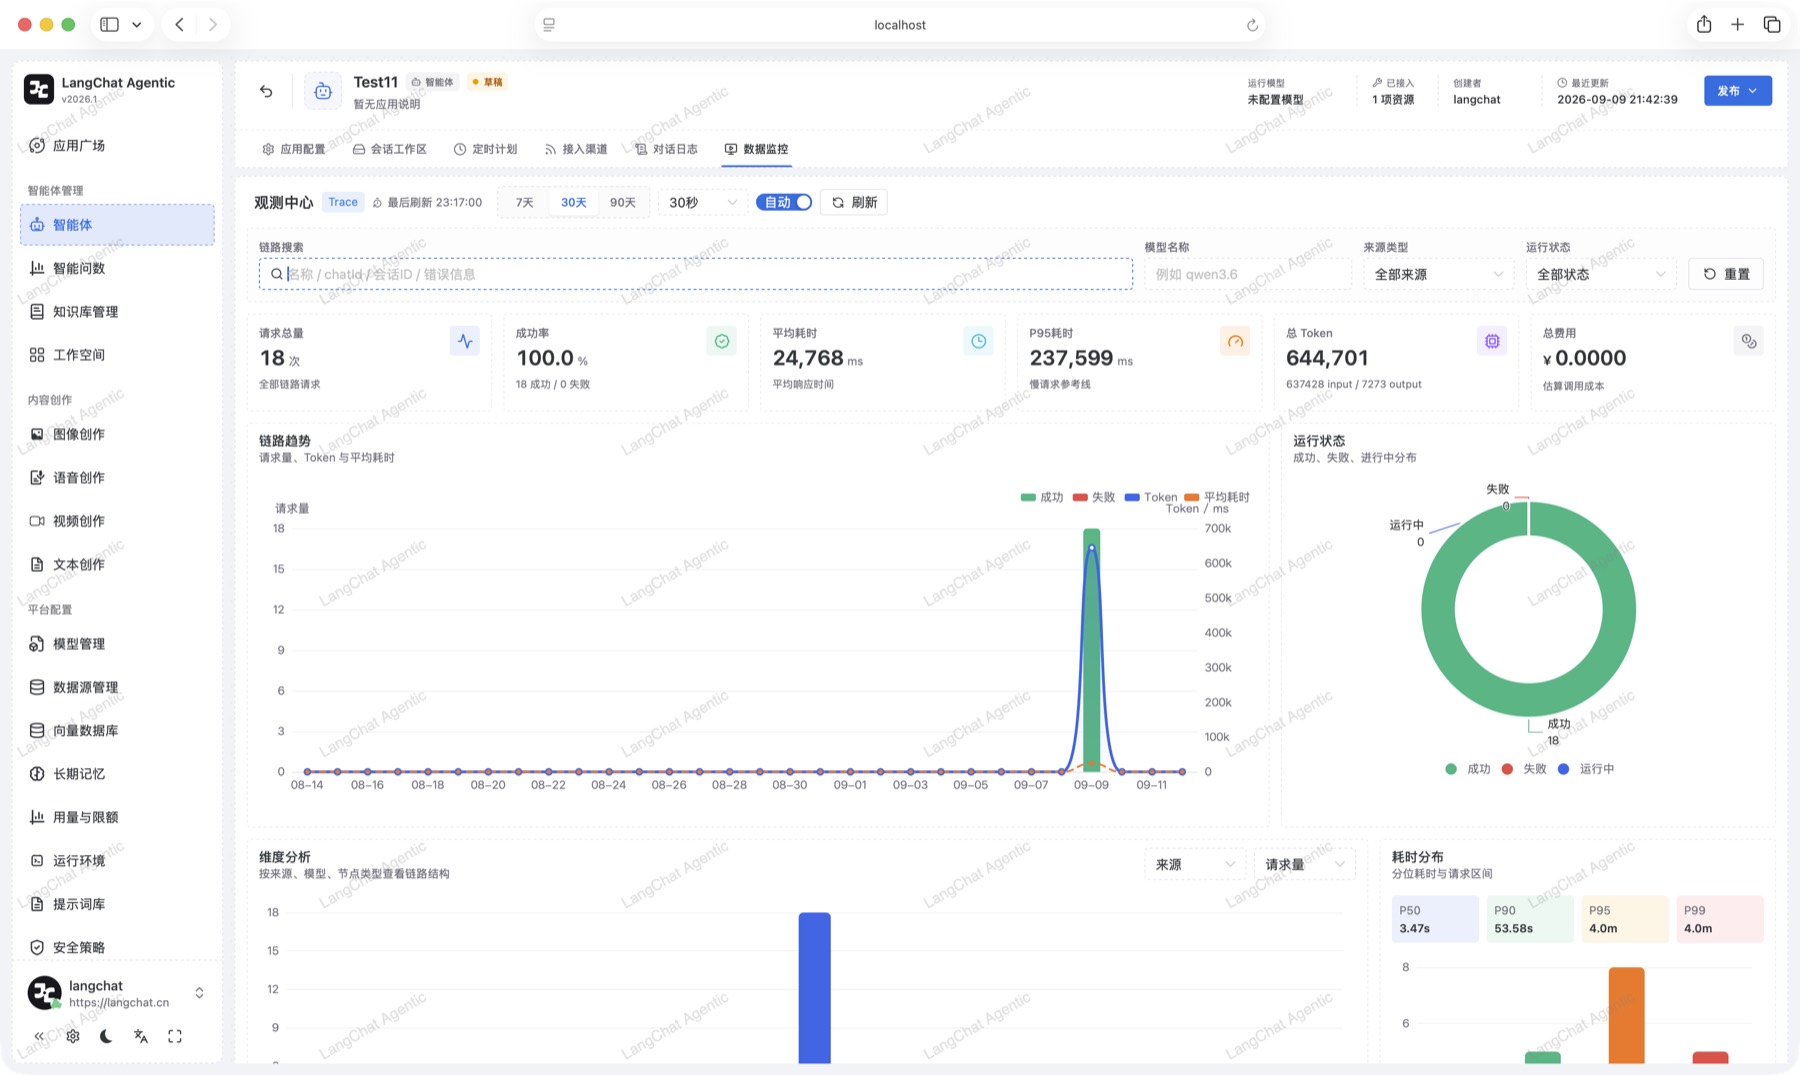
三类智能体共享同一套运行能力:对话日志记录每次会话与工具调用,调用监控与数据监控呈现运行质量,接入渠道与定时计划决定服务的触达方式。应用同时支持细粒度数据权限,可按组织或个人分配,并分别控制编辑应用、删除应用、查看应用日志等操作权限。
对话日志:记录会话与运行过程
11
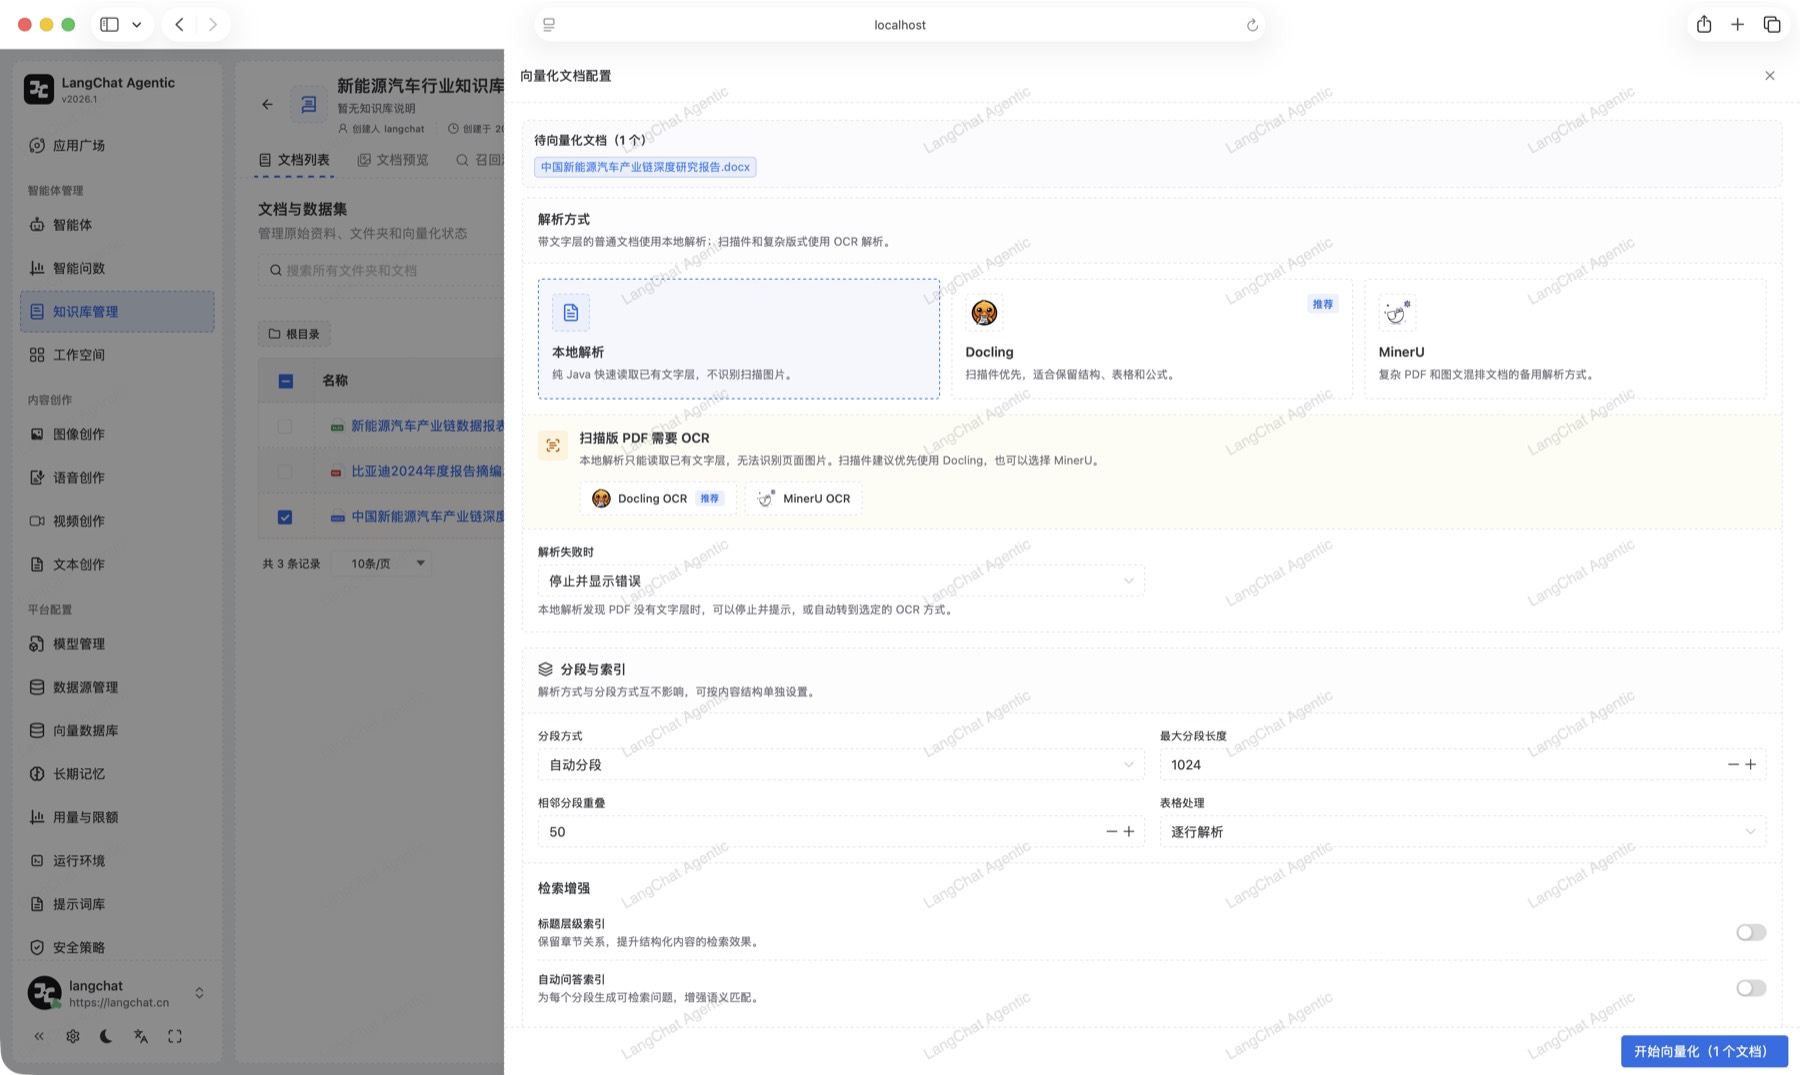
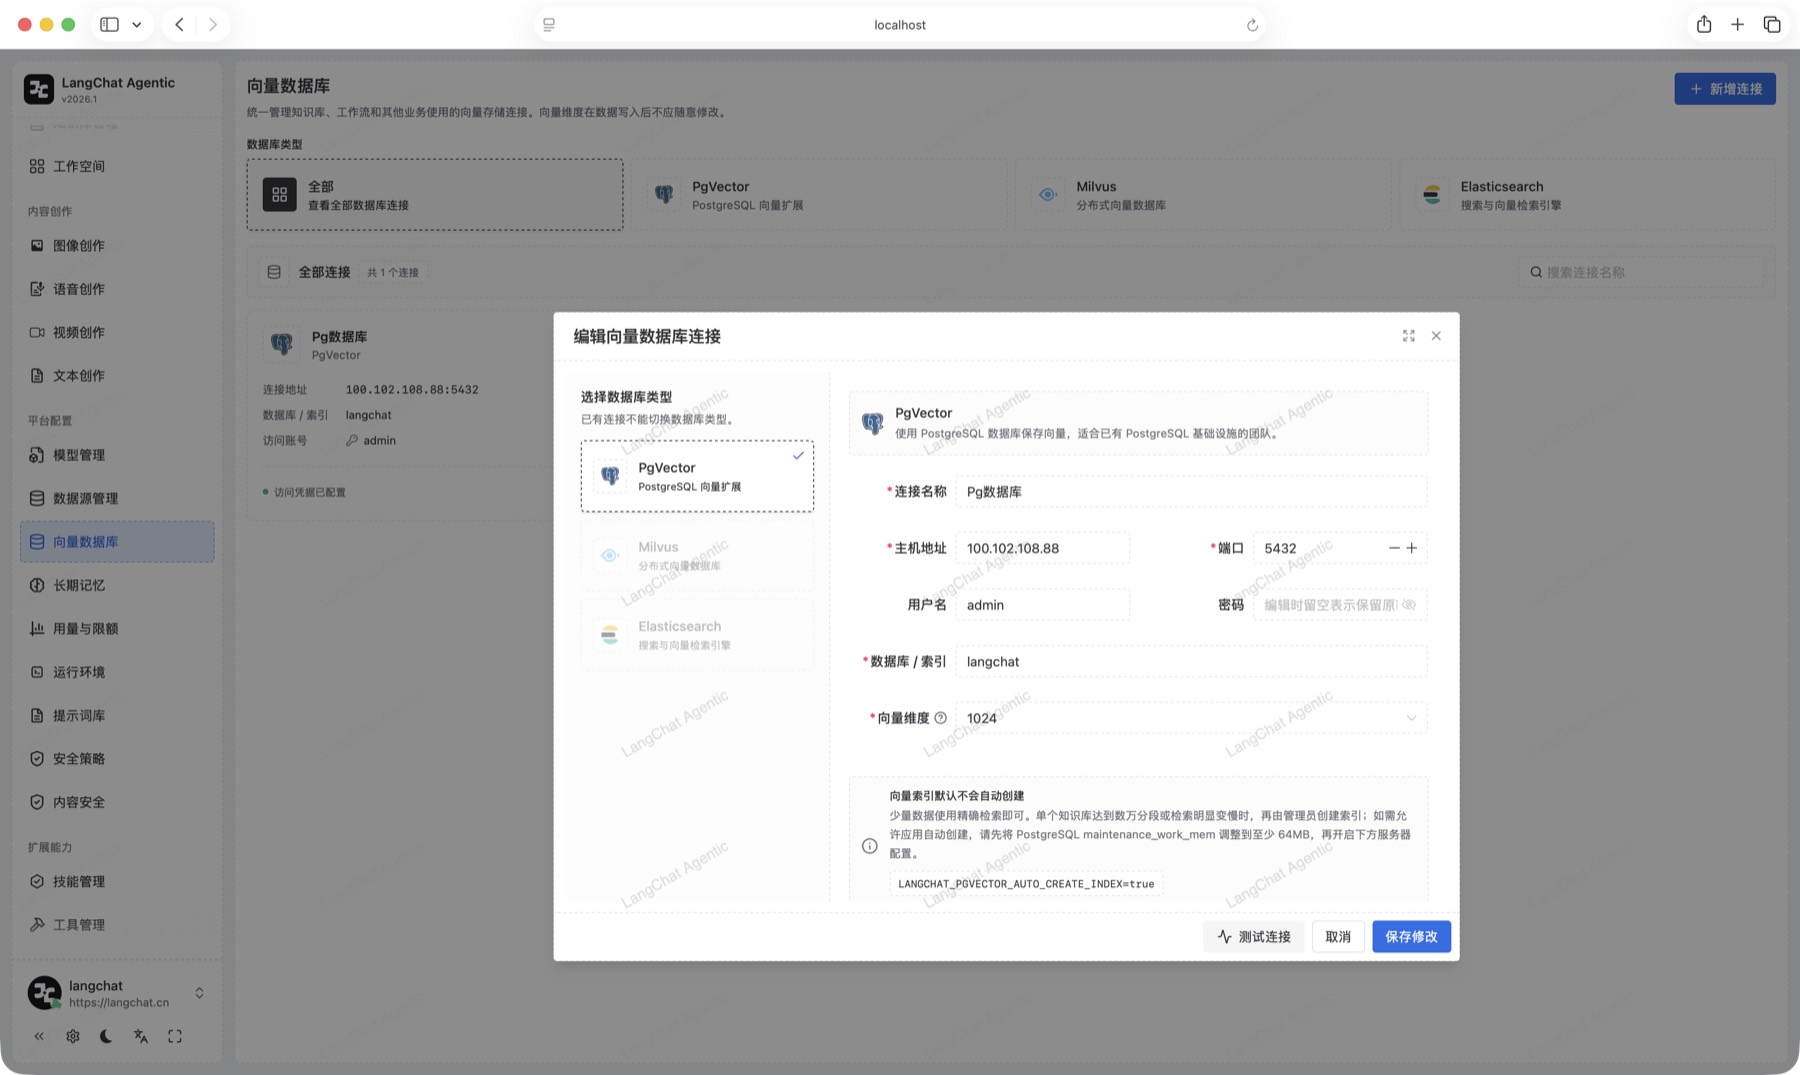
知识库支持常见的三种向量化数据库,文档解析基本覆盖大部分文档类型,并针对 Excel 表格数据做了进一步优化。向量化时可配置增强索引,并对向量化后的文本分段手动标注索引,提升结构化内容和语义匹配的检索效果。
知识库文档列表:解析状态与向量化进度
12
每个知识库都可以选择语义、全文或混合检索。平台会根据所选的 PgVector、Milvus V2 或 Elasticsearch 连接,自动收敛可用的距离算法、稀疏来源、融合方式与索引参数。混合模式同时执行语义召回和全文或稀疏召回,再通过 RRF 或 Weighted 融合,并可继续调用重排模型完成精排。
更换嵌入模型、向量维度、距离算法、稀疏来源或物理索引参数时,系统会创建独立索引版本,而不是覆盖当前活动索引。新版本构建期间旧版本继续提供查询,只有全部索引成功后才原子激活,构建失败不会影响线上检索。
13
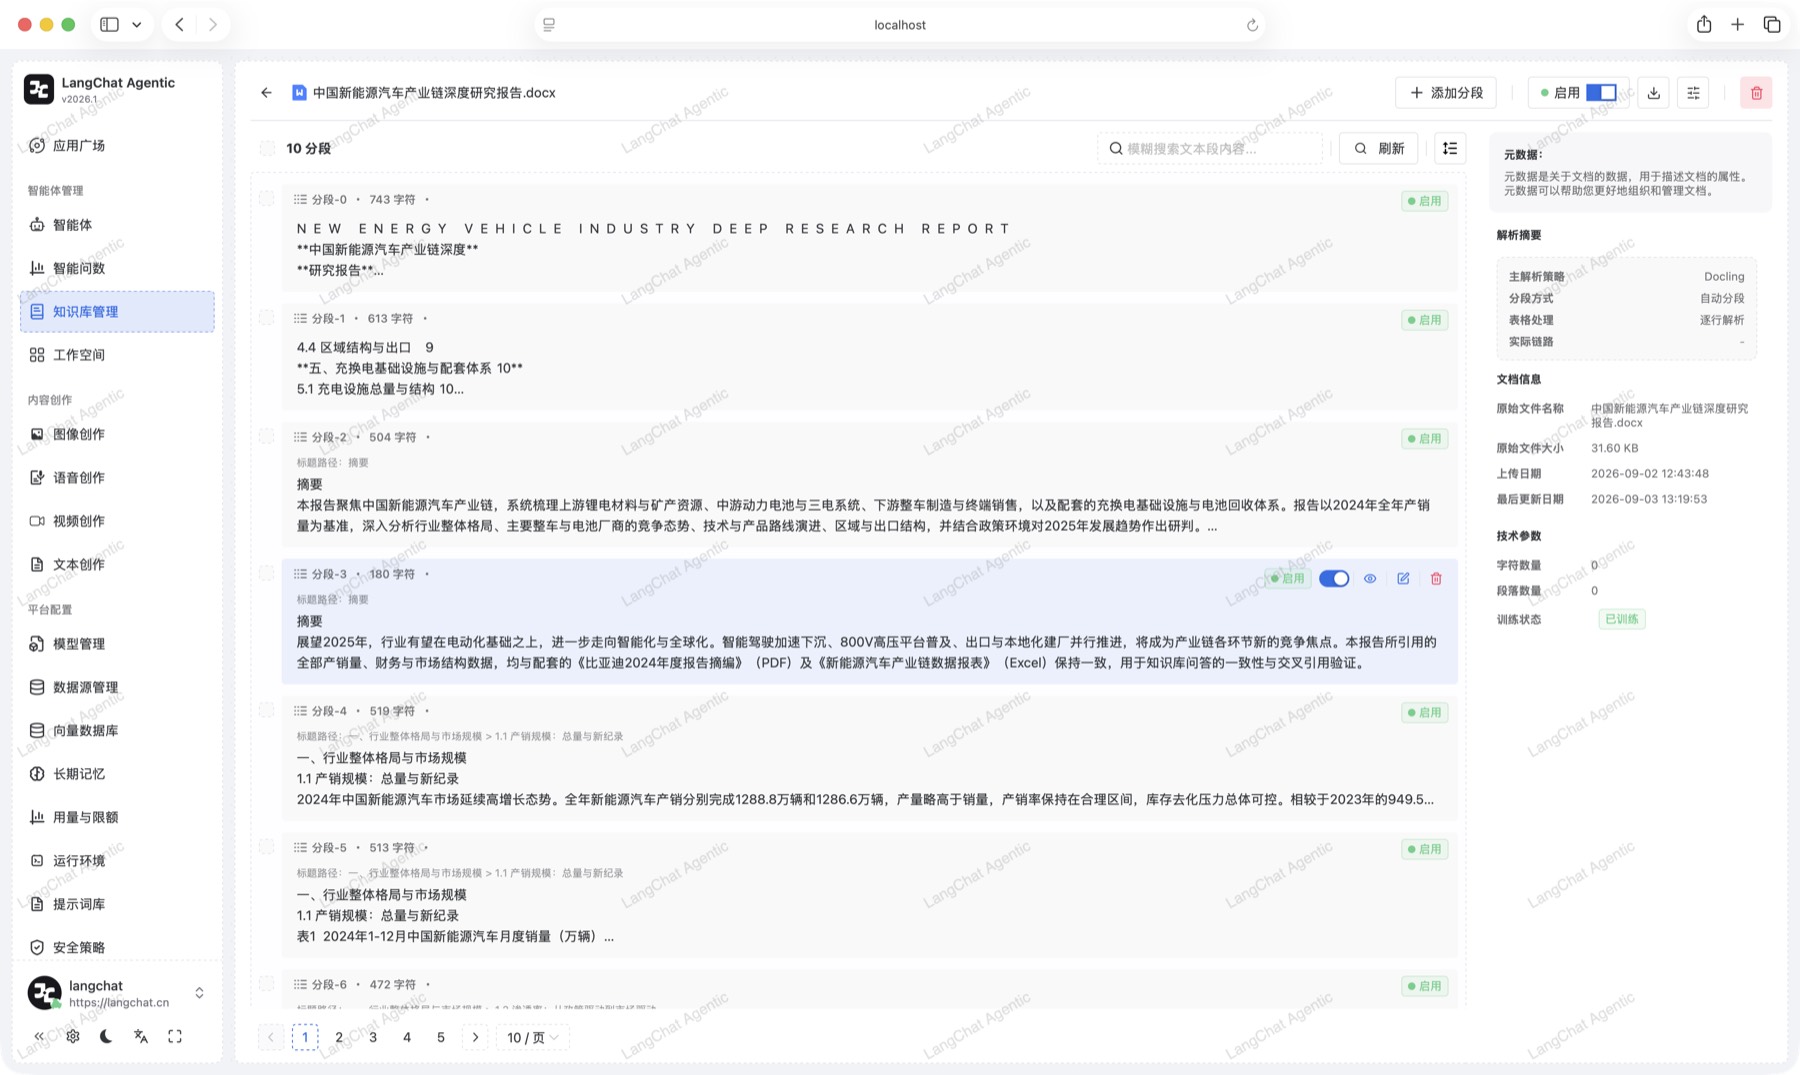
文档拆分后支持在线预览,涵盖各种 Office 文档,并完整呈现知识库文档的分段信息。分段支持在线编辑、重新向量化以及配置是否启用,便于在导入后持续修正切分质量,让检索链路可解释、可调整。
文档预览:保留版式的 Office 文档在线查看
14
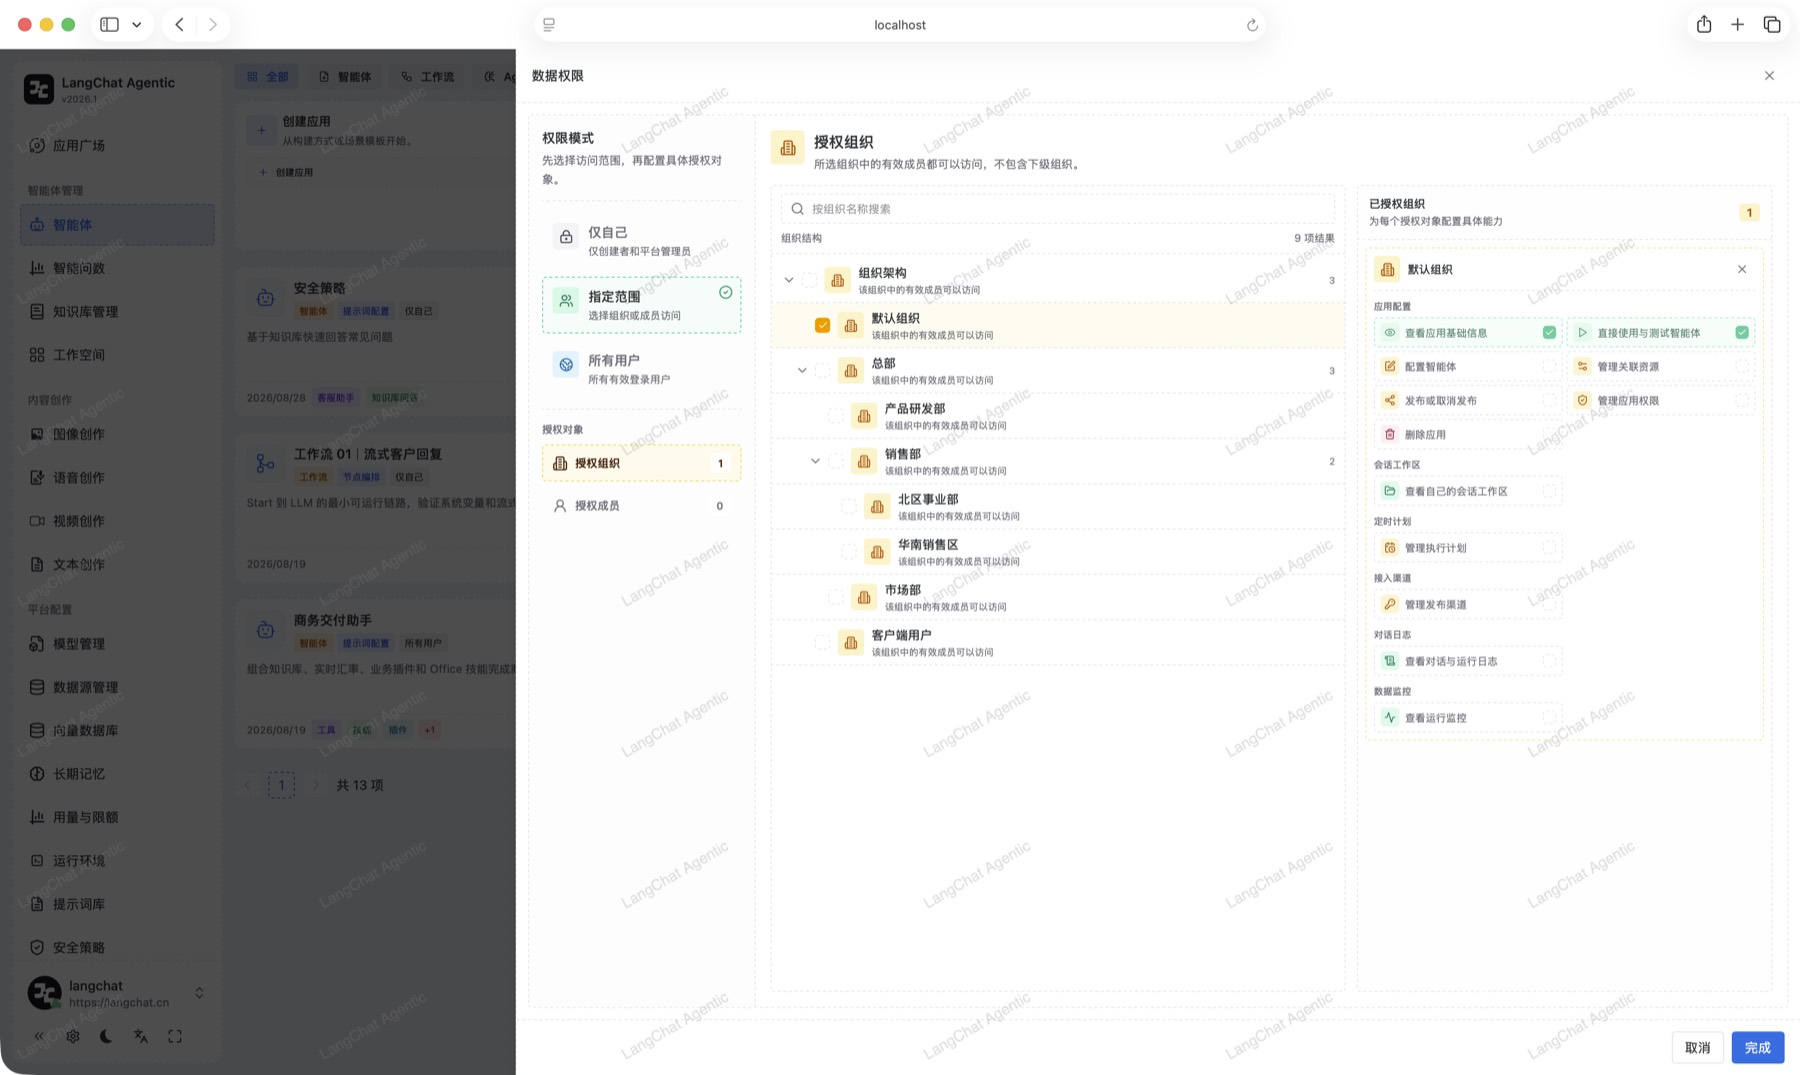
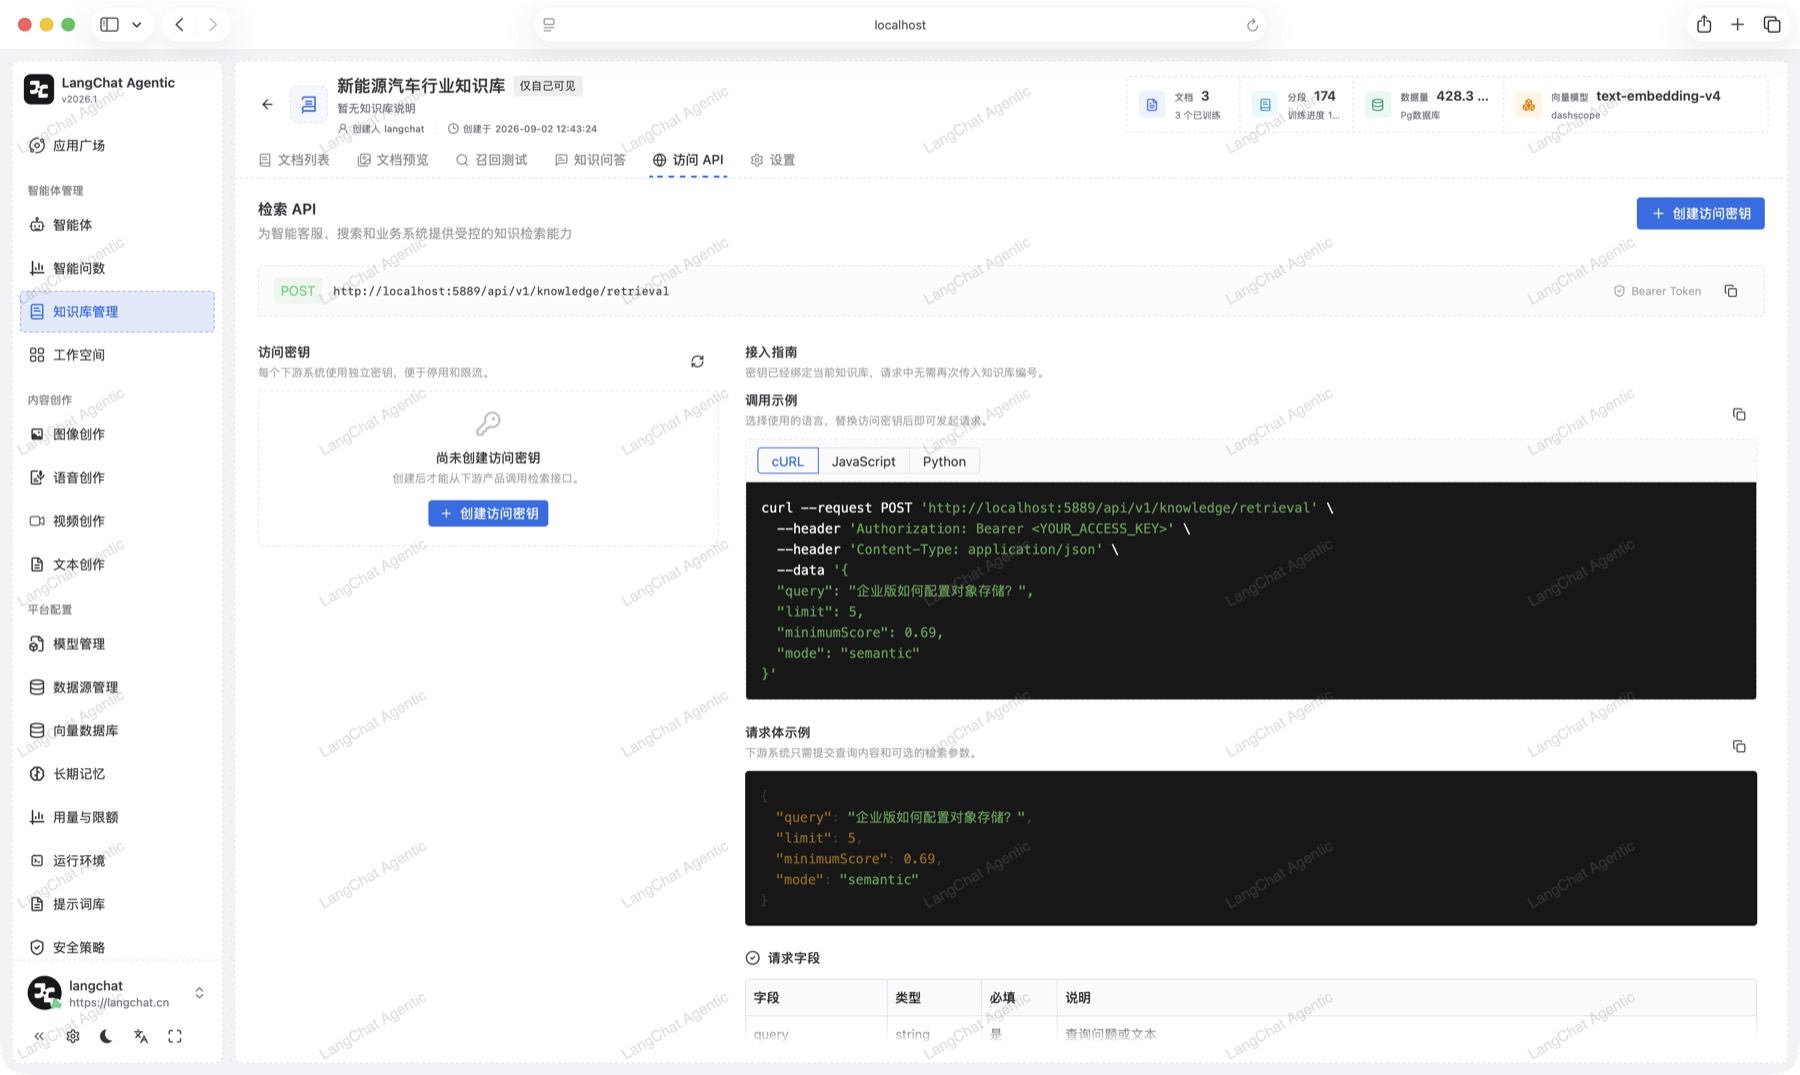
知识库支持细颗粒度的权限控制,可以分别限定用户能否删除文档、编辑知识库、查看知识库配置等,并按用户维度或组织维度共享数据。同时支持添加访问密钥,通过 API 把知识库检索能力对接给下沉的智能客服、搜索和业务系统。
知识库数据权限:授权组织与文档、分权权限
15
智能问数把数据源下的可用表纳入分析范围,每次提问自动选择必要的数据表,用自然语言完成取数与计算,并直接输出结果表格与图表。查询范围、耗时与结果都可回看,让业务人员在受控边界内自助完成数据分析。
16
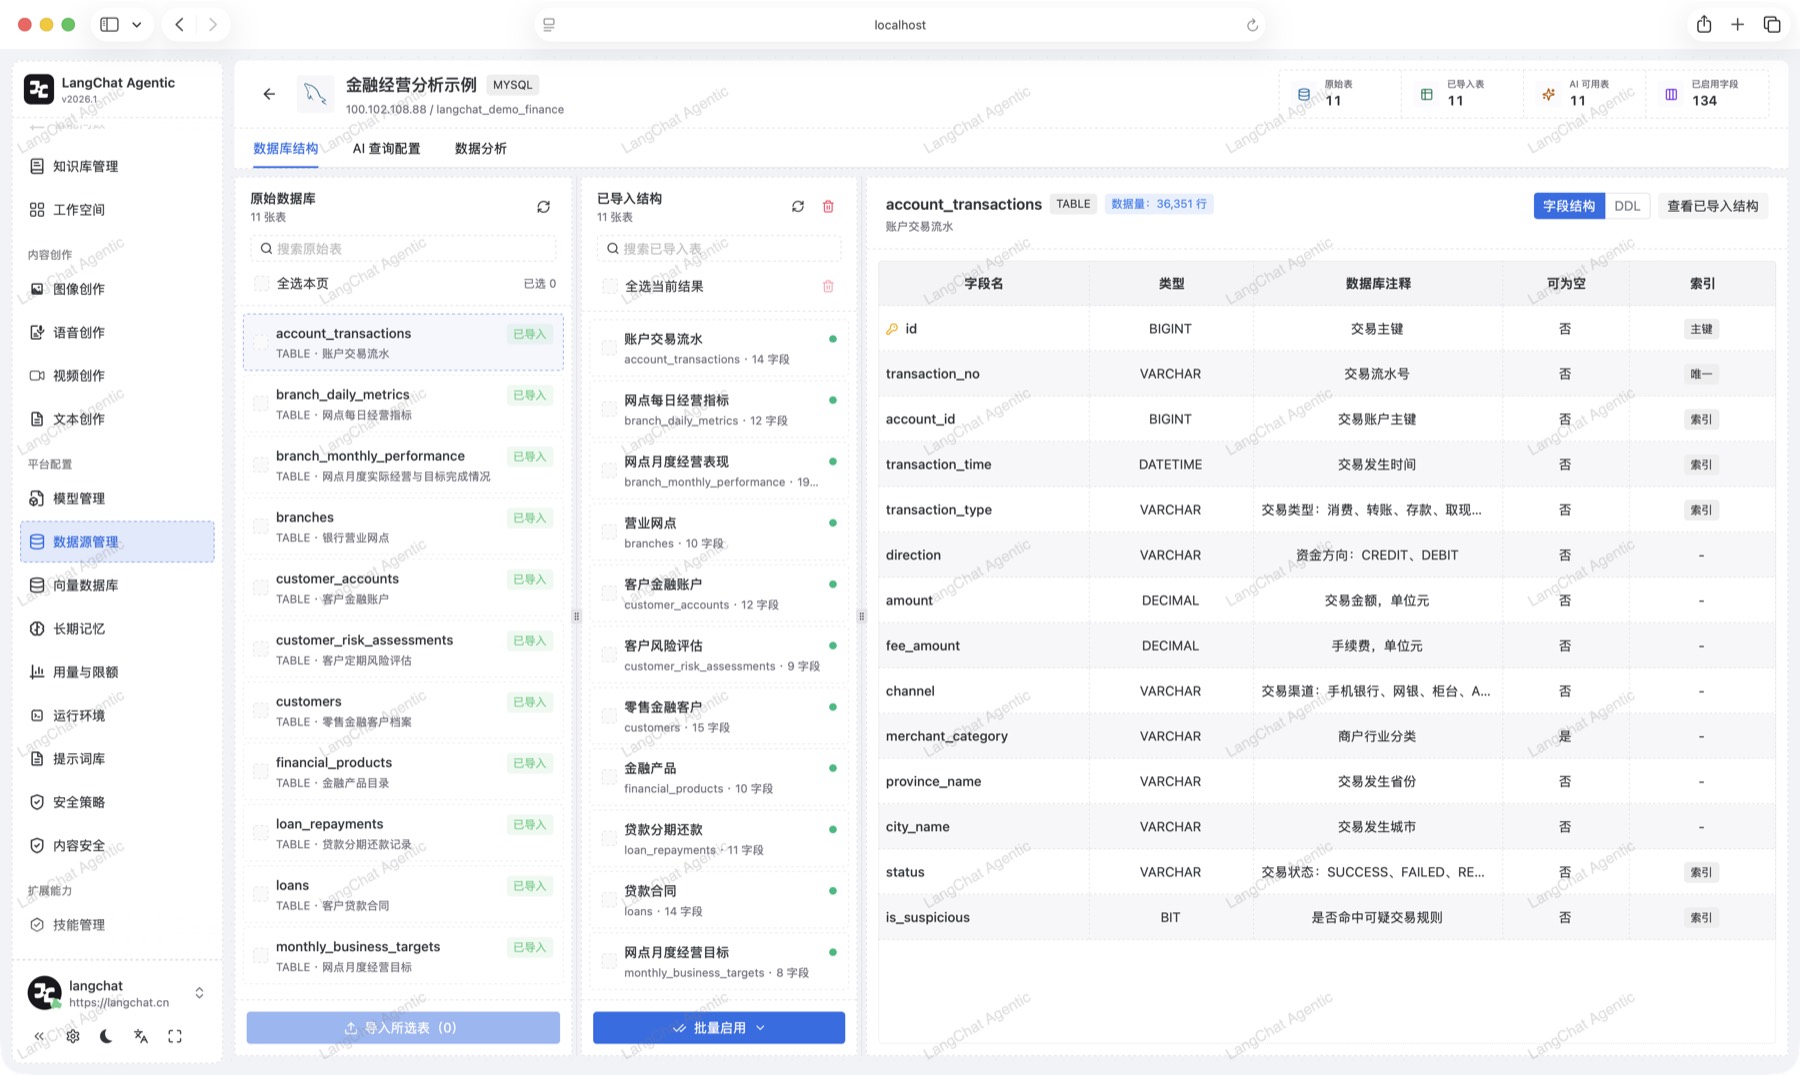
数据源模块支持大量信创数据库以及常见数据库类型,并可按部署环境选择关闭 TLS、仅加密连接或完整校验证书与主机身份。接入之后可以查看原始的表结构信息,选中原始表并导入到自定义表,形成统一的可分析边界。
数据源配置:接入数据库并管理表范围
17
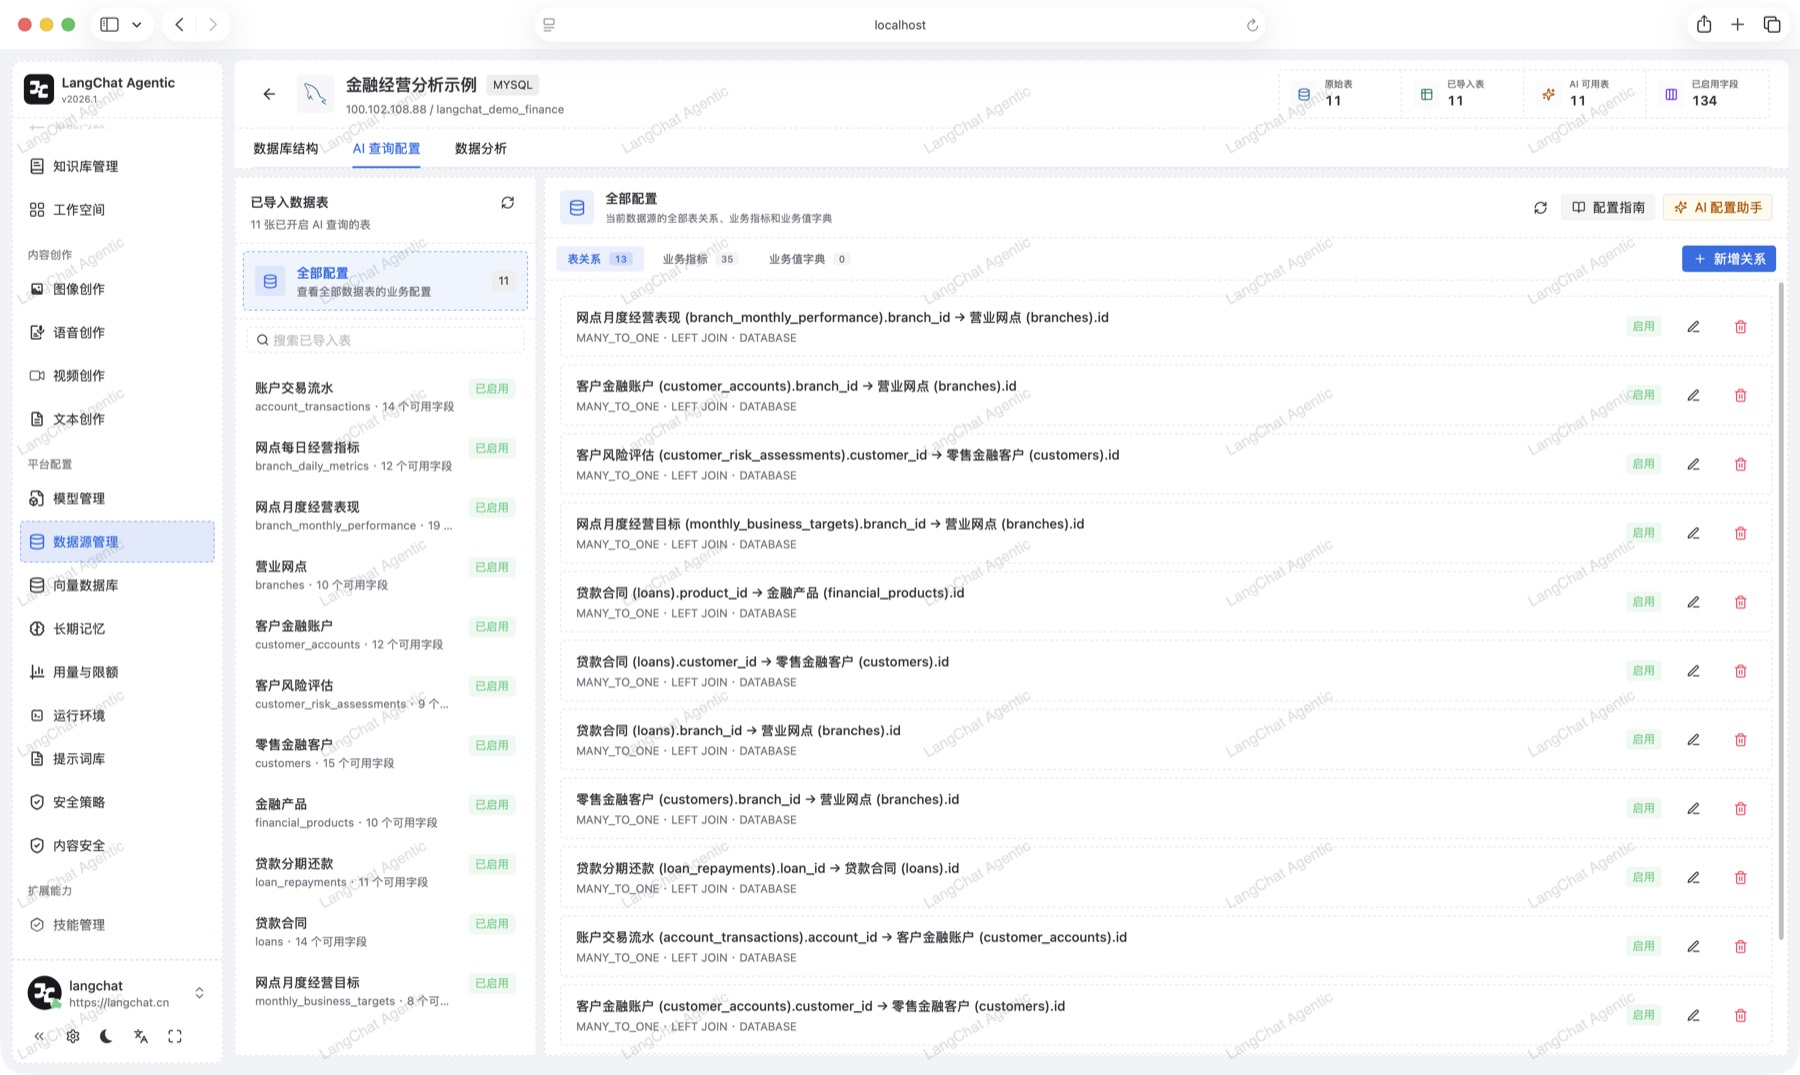
导入后可以定义每张自定义表的字段信息,补充字段含义与说明,并为整张表增加语义化描述。AI 查询配置页面进一步为数据表增加语义化配置,包括表与表之间的关系、表与字段之间的关系以及字段的枚举定义,帮助 AI 更好地理解业务表结构。
自定义表结构:字段含义、补充说明与字段角色
18
内容创作把图像、视频、语音和长文本生产纳入同一套界面,支持配置模型与提示词后直接生成,并在列表与详情中管理已生成的产物,让内容生产可以被复用、被追溯,而不是一次性的对话结果。
图像创作:配置模型与提示词生成图片
19
模型管理把对话、视觉、嵌入、重排、图像、语音与视频模型统一为可替换的资源池,既支持主流云服务,也兼容 Xinference、vLLM 等 OpenAI 兼容私有运行时,并显式治理向量维度与 Dense、Sparse 输出能力。PgVector、Milvus V2 与 Elasticsearch 则构成可替换的知识检索底座。
模型管理:统一维护模型资源池
20 / Model Routing
模型路由让应用绑定一个稳定的逻辑目标,由平台在运行时选择真正执行的物理模型。路由可以先按平台、组织或用户限定使用范围,再按有序的用户与组织规则选择候选模型,使智能体、工作流、知识加工和内容生成不再绑定某个供应商或私有化实例。
按优先级调用候选,仅在安全且可重试的瞬时故障中切换备用模型
按相对权重分配首选模型,适合灰度发布、成本分配和不同容量实例
在同规格私有模型实例间依次轮转,均匀分散新请求
应用通过同一个模型选择器自由选择物理模型或模型路由
规则支持用户与组织条件,AND/OR 语义和未命中行为均明确可见
编译后的路由快照让数据库与 Redis 退出请求热路径
21
决策模型把结构化选择、分类与评分作为独立模型能力。LangChat 以 TypeSafe System One 请求与响应契约统一封装供应商差异;TypeSafe 托管模型、Ollama 部署以及兼容 System One 的服务,都可以通过同一个入口供工作流决策节点调用。
22 / Responses API
Responses API 为外部系统提供一套同时覆盖模型生成、状态续接、函数交接和平台事件的结构化协议。登录态应用通过 `POST /responses` 直接选择模型,无需绑定 Agent ID;已发布智能体则通过原有渠道密钥、访客隔离、限流、工具授权、安全策略和审计链路暴露 `POST /v1/responses`。两类入口在内部都汇入与传输协议无关的 ChatEvent 运行时,因此平台可以增加 Responses 协议,而不需要替换既有 Chat Completions 接口,也不会让业务模块绑定某一种流格式。
登录态
POST /responses直接选择模型,无需绑定 Agent ID
公开渠道
POST /v1/responses沿用渠道认证、限流与 Agent 授权
协议转换路径
请求校验与映射
统一 ChatEvent 运行时
Responses JSON / SSE 投影
通过 JSON 或带事件类型的 SSE 输出响应生命周期、文本增量、输出项、用量、不完整状态和 OpenAI 风格错误
直接模型调用可声明函数、流式接收参数并保留 call ID,由调用方执行后通过 function_call_output 继续
在按身份隔离的 Redis 空间保存响应,通过 previous_response_id 续接,并支持查询、删除和后台取消
工具、检索、工作流、权限与工作区进度统一输出为 langchat.event,无需逐个重构事件生产者
Agent 已配置工具继续由平台执行,避免外部调用方重复执行同一工具
对托管工具、多模态 item 和缺少可靠运行语义的字段明确返回能力错误,不做静默降级
23
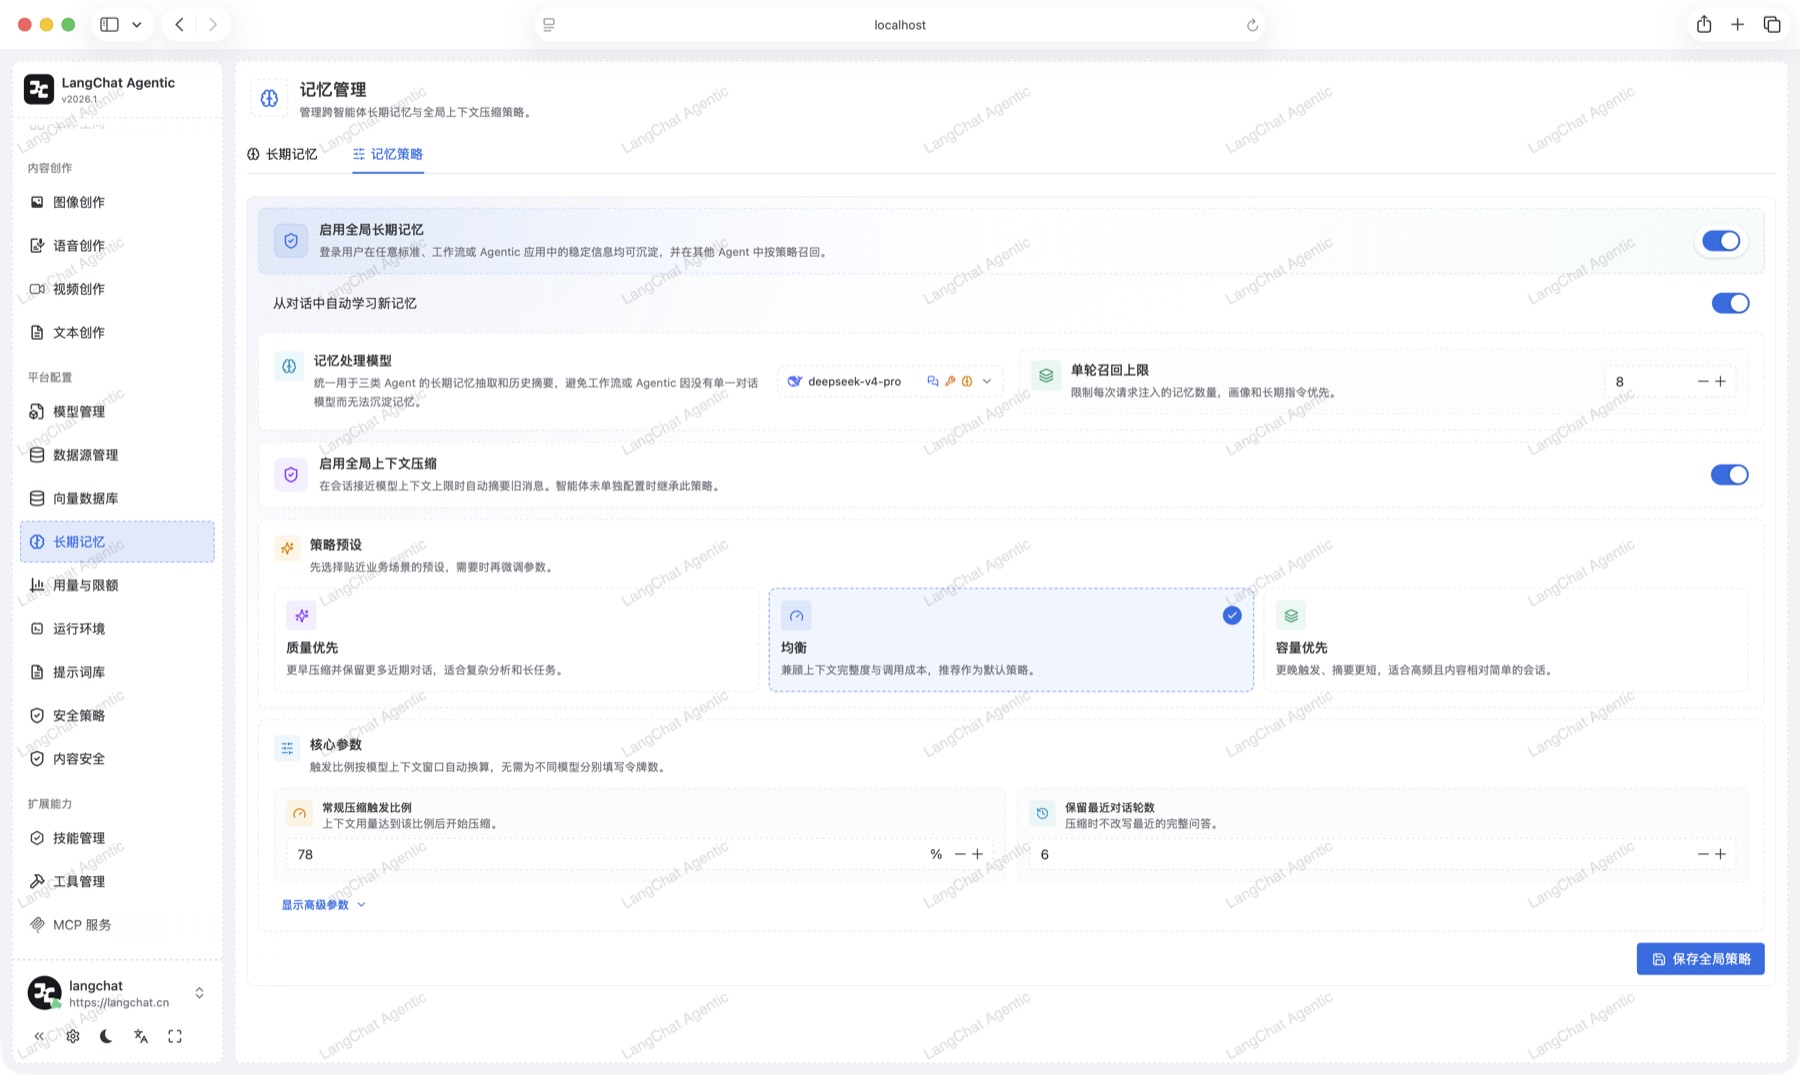
长期记忆沉淀全部记忆、长期指令、用户偏好、项目事实、用户画像和其他类别,既有聊天过程中自动沉淀的记忆,也有用户自行添加的全局记忆。记忆压缩会统计会话所占用的 token,超过模型上限时自动触发压缩,并支持配置质量优先、均衡模式和容量优先模式,以及触发比例与保留对话轮数。
长期记忆:记忆分类、来源与启停管理
24
用量与限额按用户维度或组织维度限定 Token 使用上限。默认不设上限,一旦配置了限额,用户聊天超过个人上限或组织上限时会被直接拦截。页面同时展示周期额度、已用与剩余 Token,以及当前对象的调用记录,让成本可控、可追溯。
25
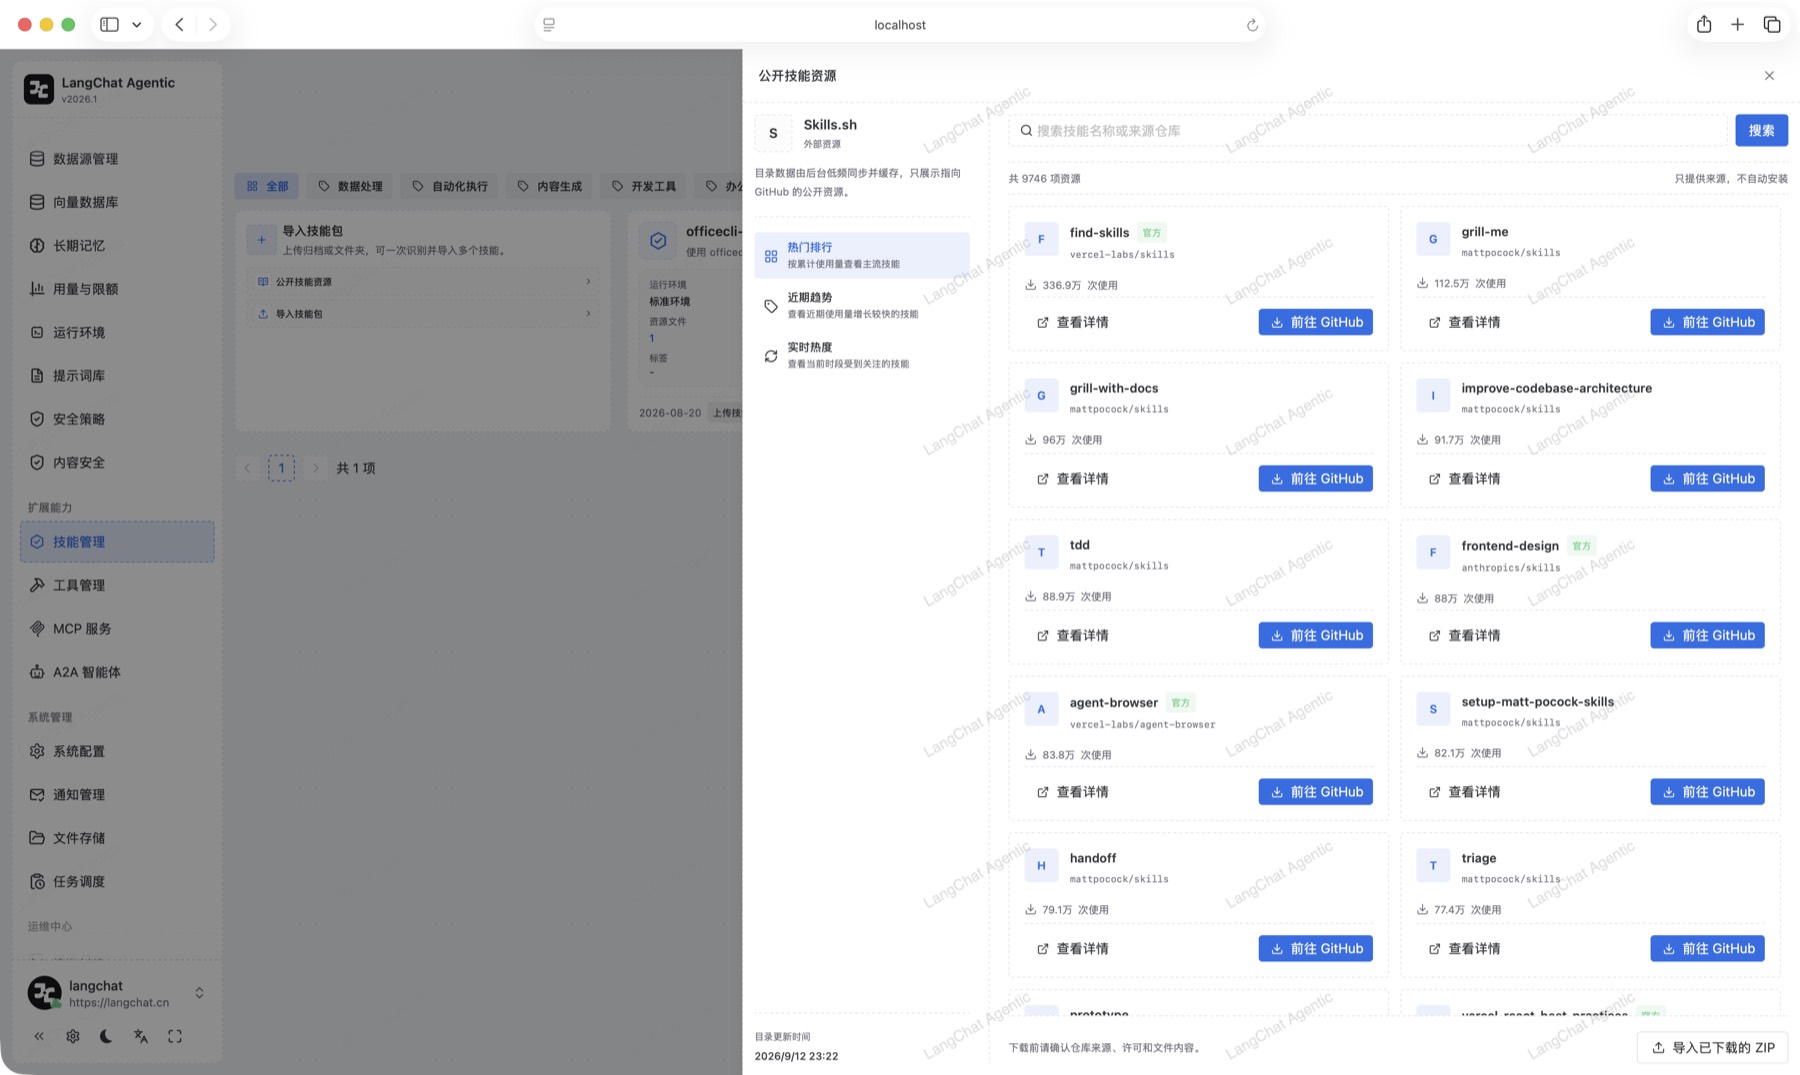
技能管理把可复用的专业任务封装为技能包,维护语义资料、触发词、适用任务与默认模型,供 AI 判断何时激活;技能市场可以按需添加技能。工具管理则通过 OpenAPI 标准规范把外部接口快速引入为可调用工具,让模型能够执行真实的业务动作。
技能管理:语义资料、触发词与适用任务
26
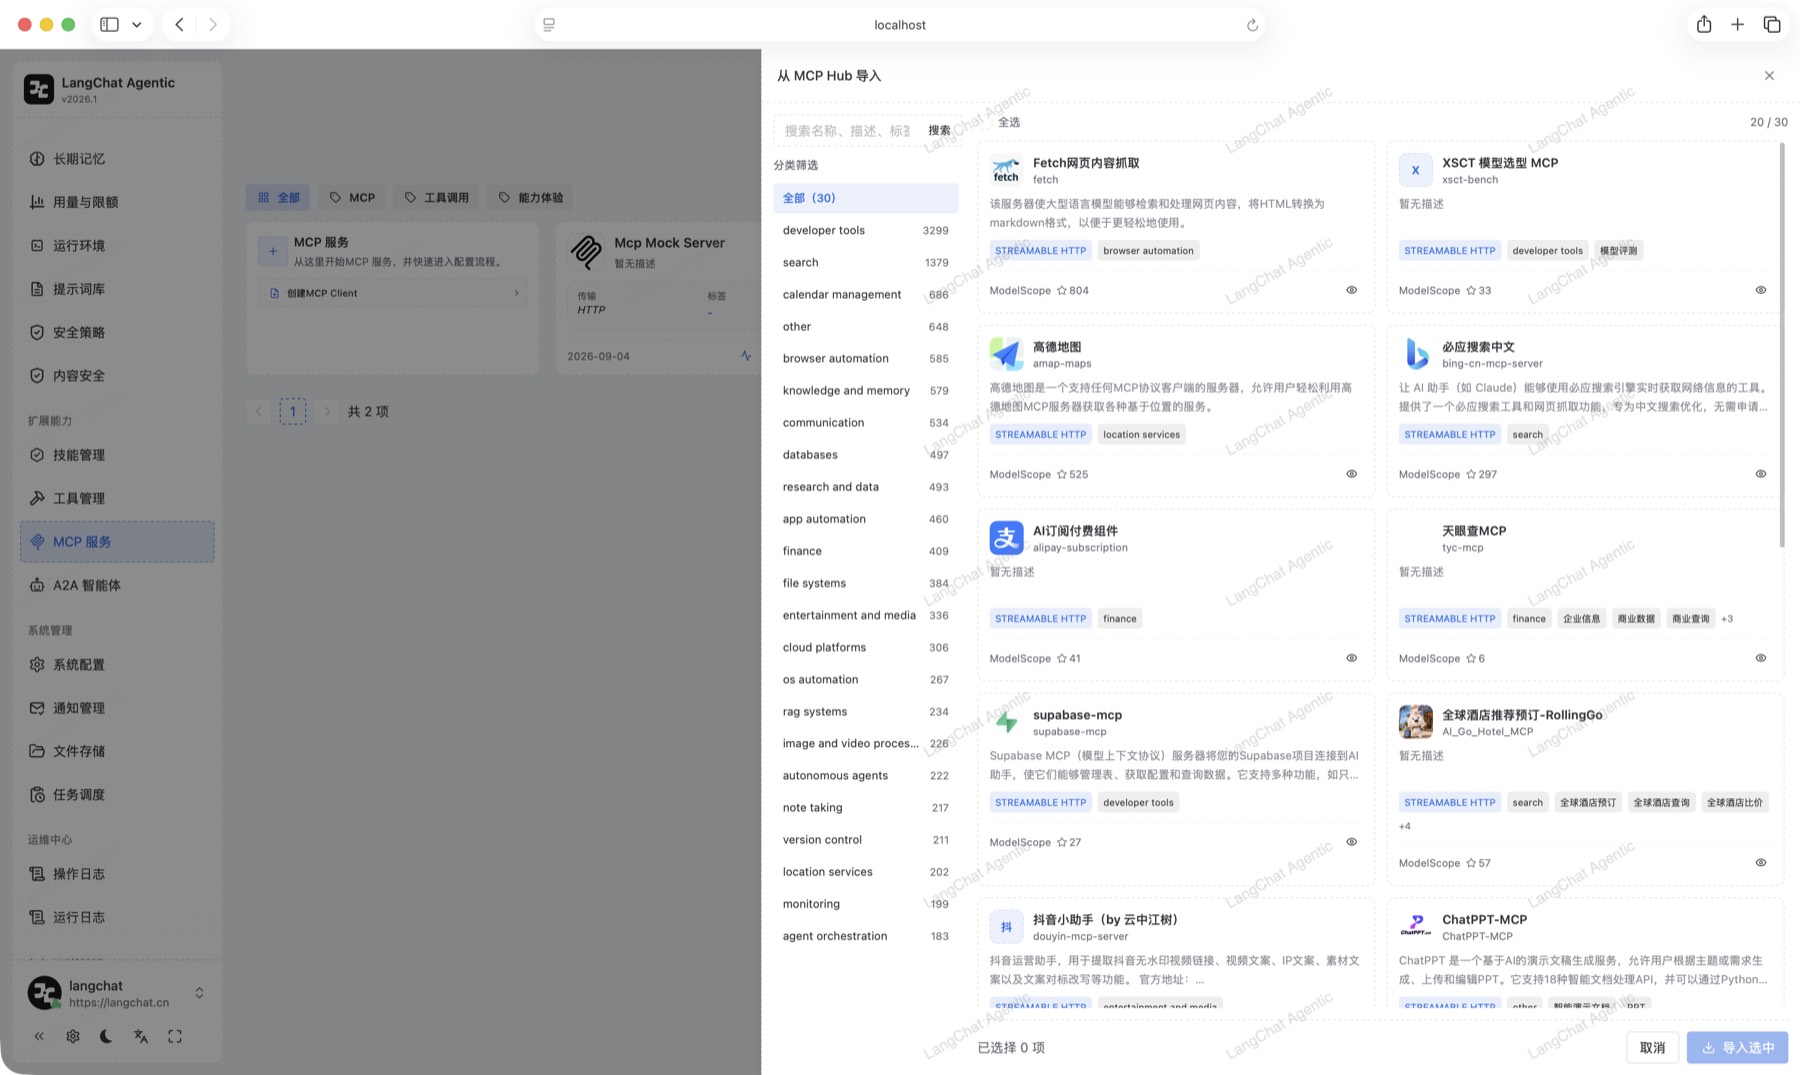
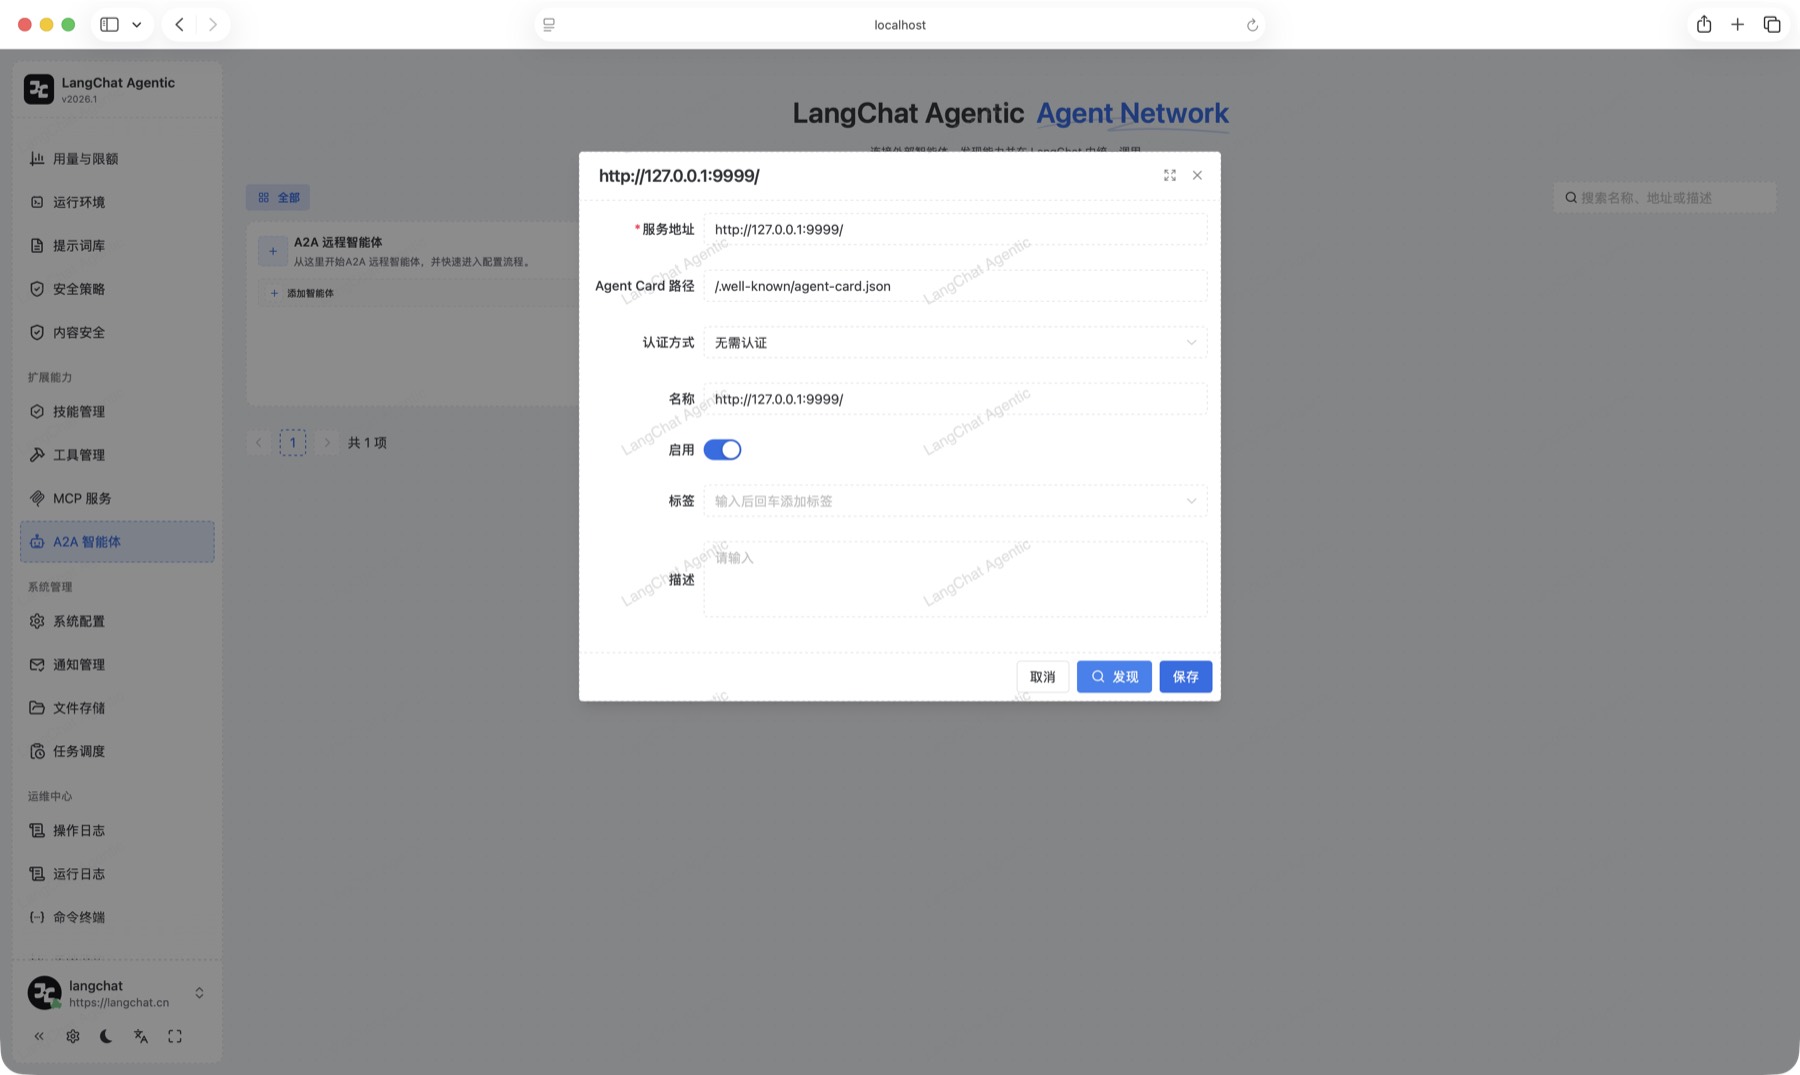
平台通过 MCP 标准协议扩展工具能力,MCP 服务与 MCP 应用市场统一管理服务的发现、配置与运行;A2A 智能体则把外部智能体应用纳入统一管理,使平台内的智能体能够与外部的智能体协作。所有智能体都支持通过 FuncCall、MCP、Skill 以及 A2A 协议接入外部业务系统。
MCP 服务:统一管理服务配置与运行
27
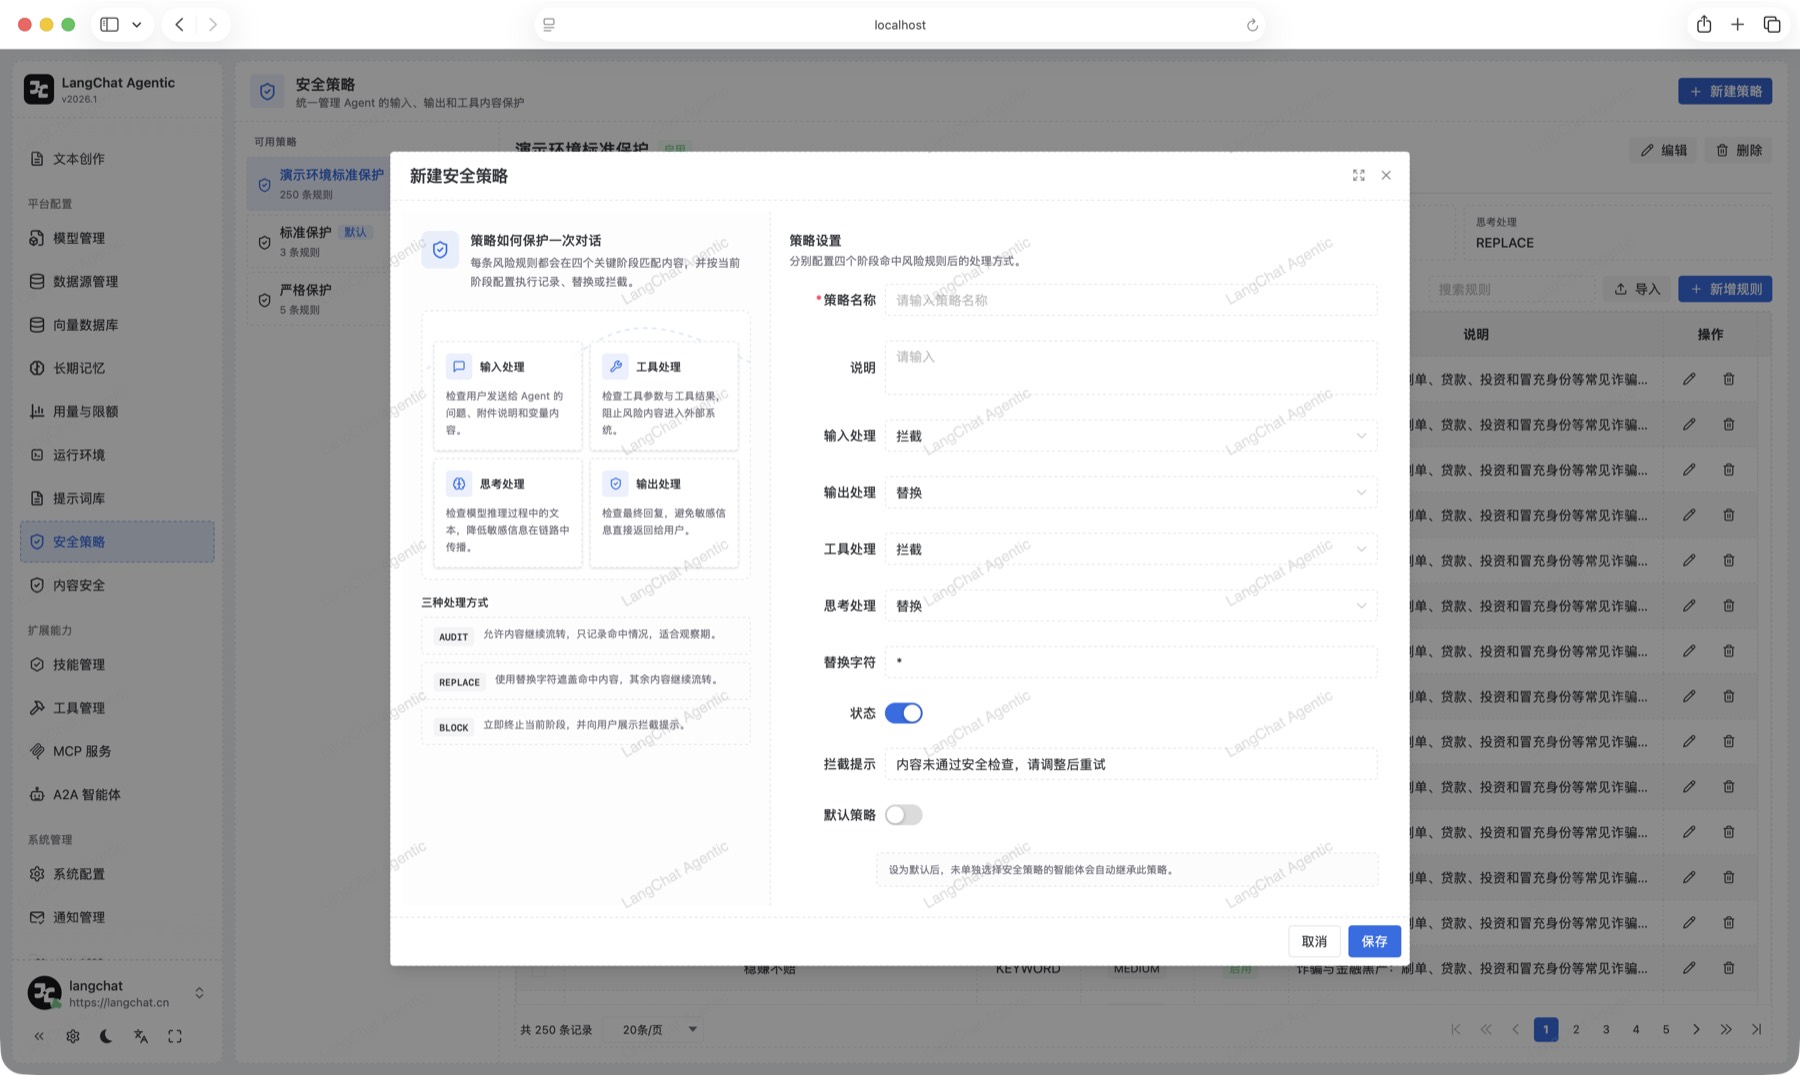
提示词库把经过验证的提示词沉淀为可复用资产,统一维护表达方式。安全策略则像一道电子围栏,针对大模型调用分别定义输入处理、工具处理、思考处理和输出处理四个阶段的策略,并可以选择拦截、替换或仅记录不拦截等处理方式。
提示词库:沉淀与复用提示词资产
28
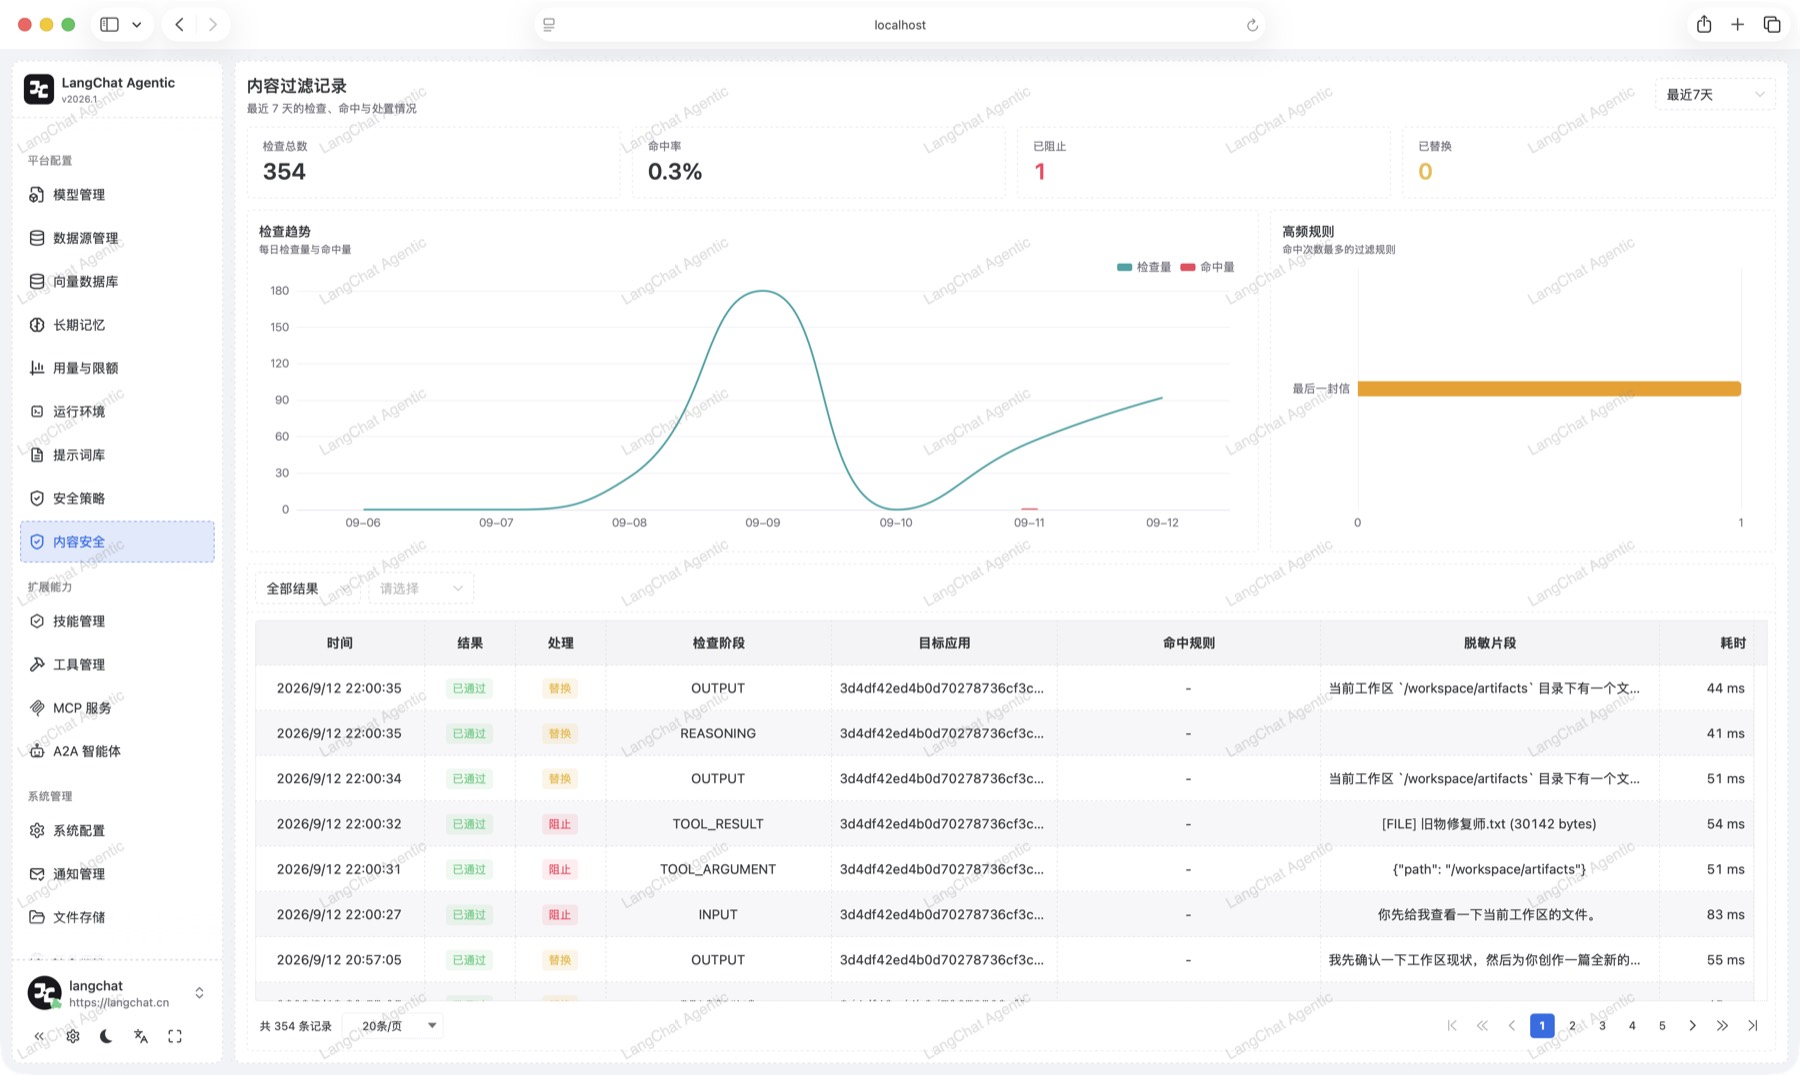
策略定义后,启用了该策略的智能体应用内的所有调用都会受管控。一旦命中,就按配置处理:例如把某个词设为敏感词并限定输入拦截,用户输入命中时直接拦截、不再调用大模型;模型输出命中关键词时,同样对输出结果做拦截处理。监控页面则记录命中信息,让策略效果可以被验证。
安全策略队列:分级策略与规则清单
29
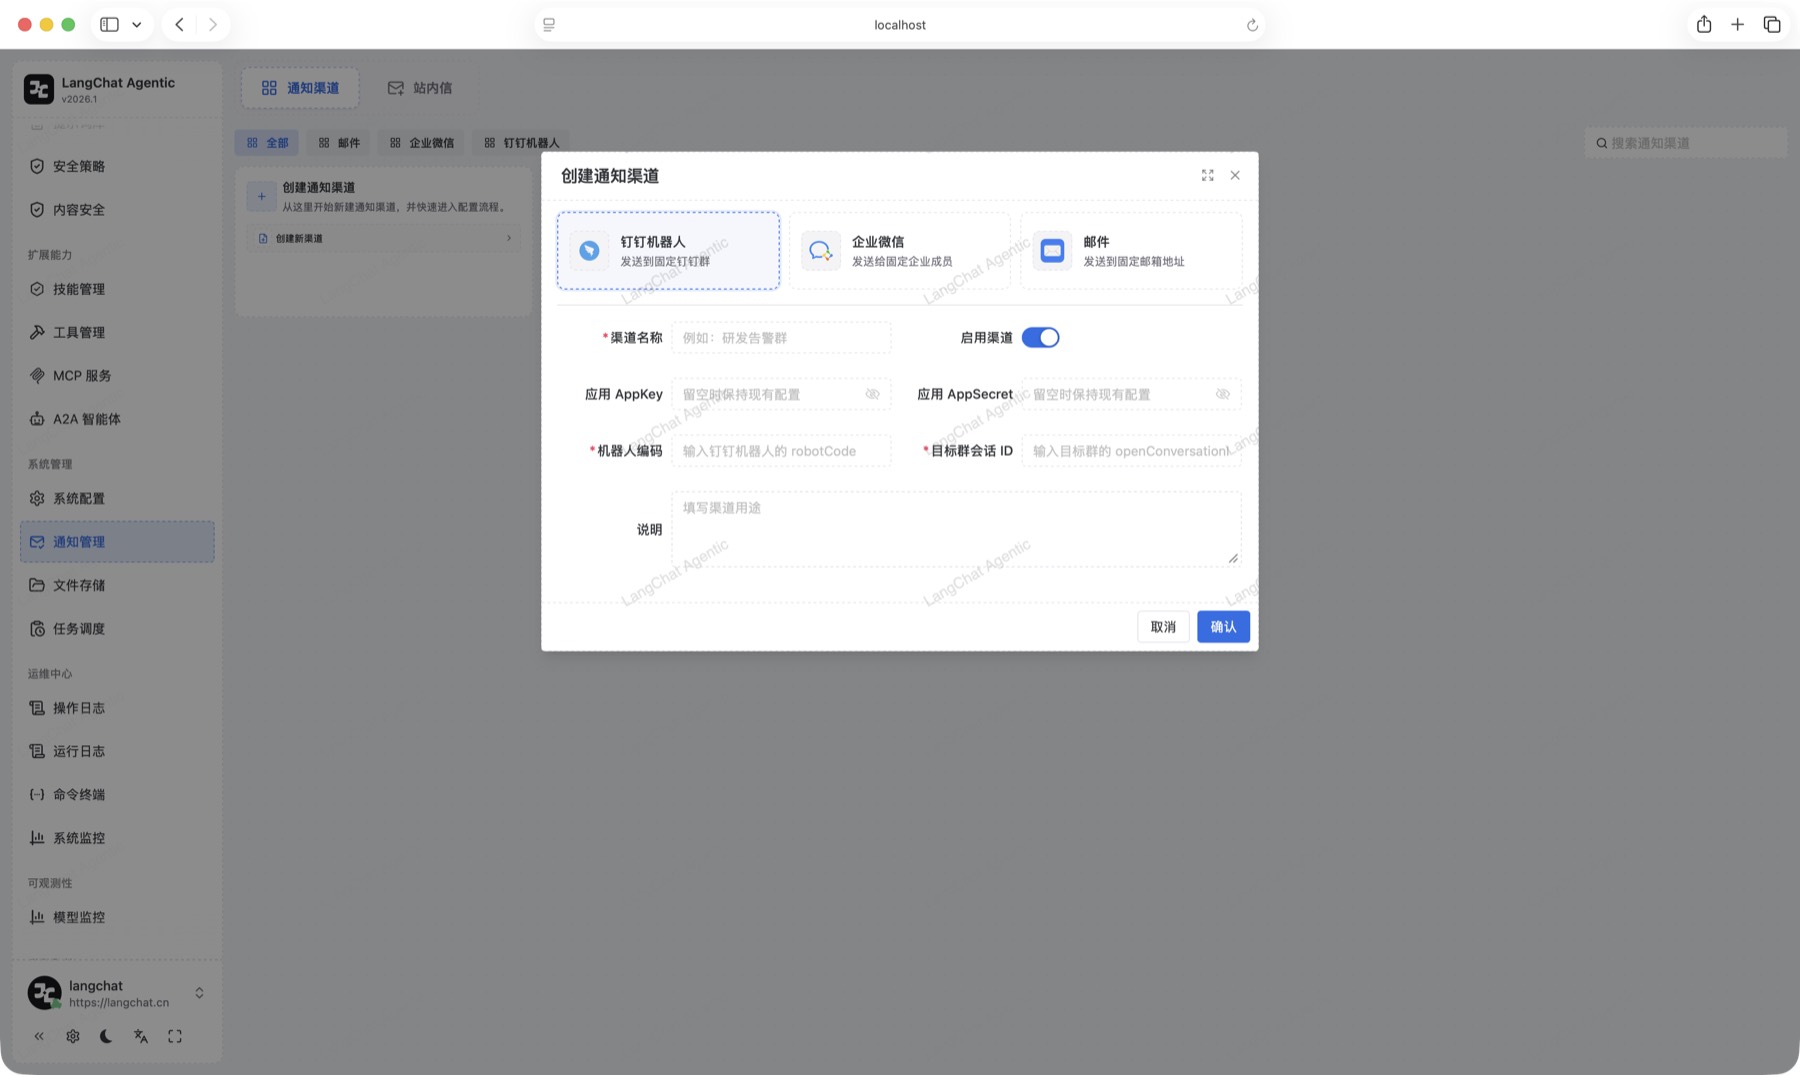
系统配置维护产品级的运行参数与品牌偏好,例如系统标识等;通知管理统一配置钉钉、企业微信和邮件等推送渠道,把任务结果、告警和站内消息按渠道触达相关人员。
系统配置:产品级参数与偏好设置
30
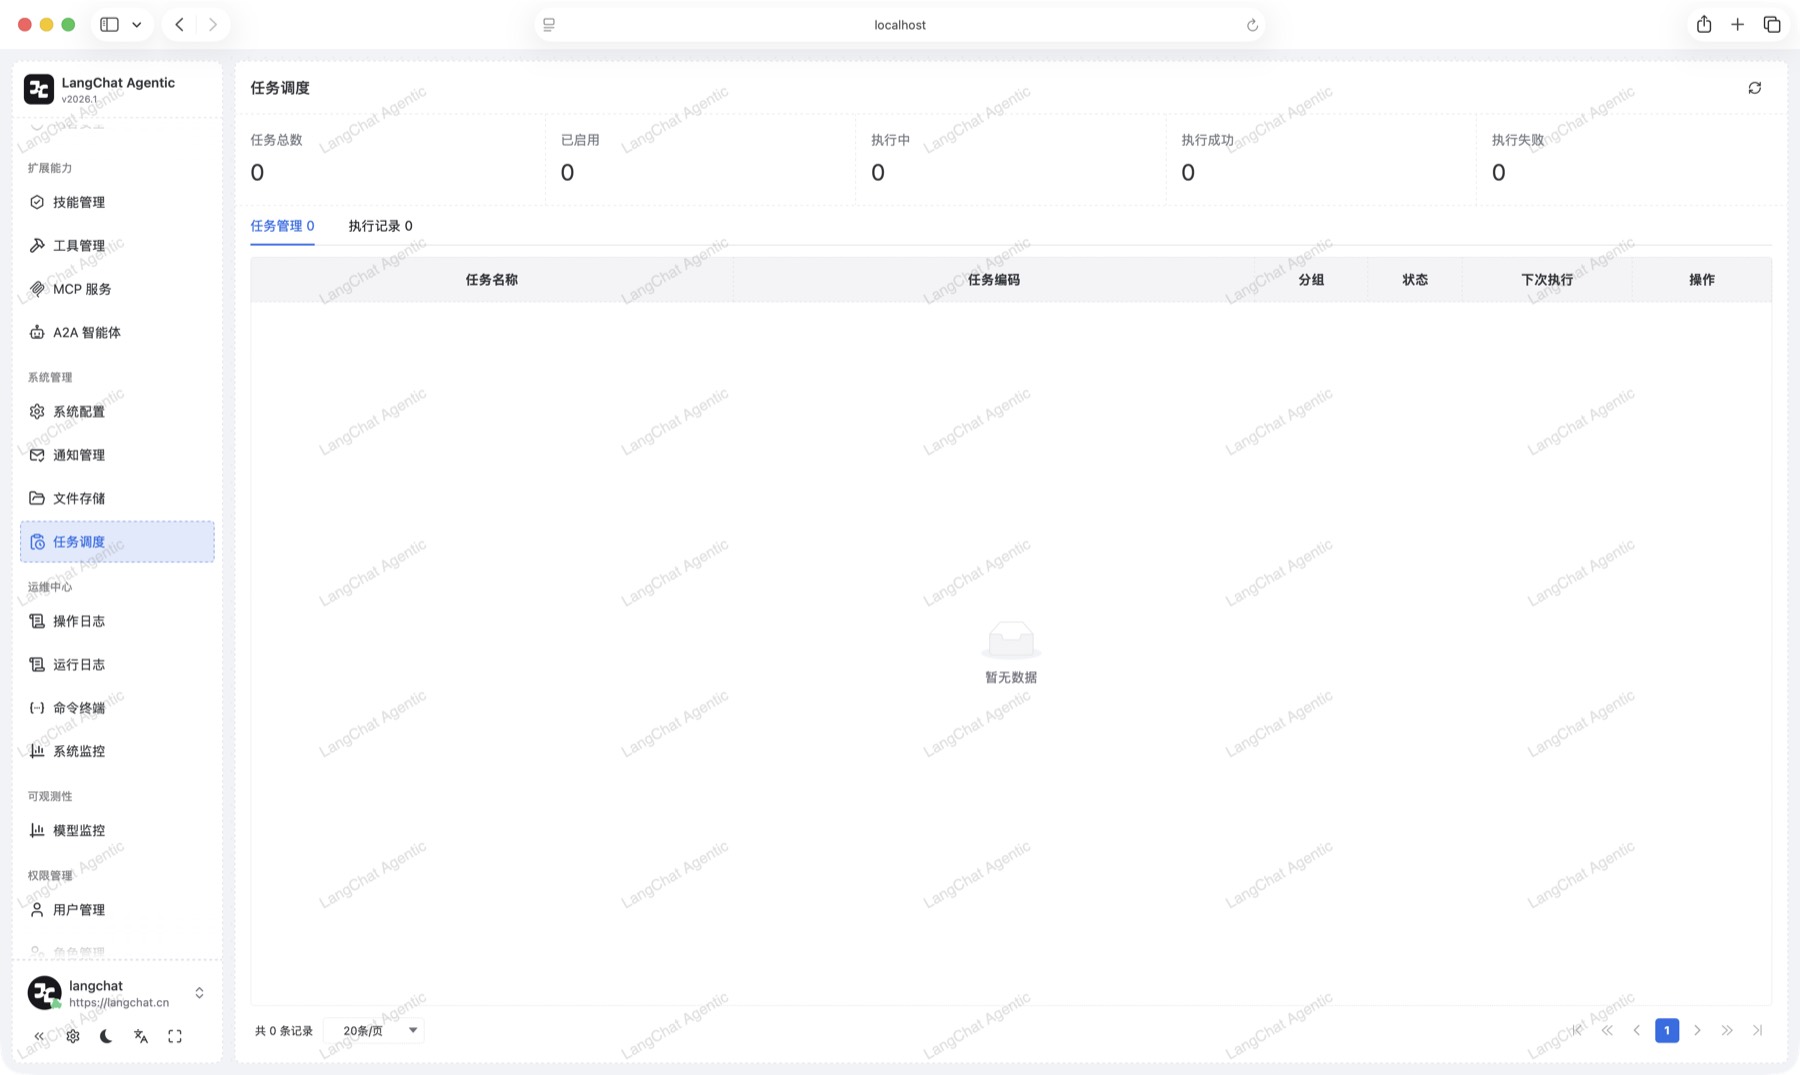
文件存储列表统一管理平台内的上传文件与产物,明确文件归属与存储位置;任务调度管理后台任务与周期任务,让数据同步、向量化、批量处理等操作可以在后台稳定运行。
文件存储:统一管理上传文件与产物
31
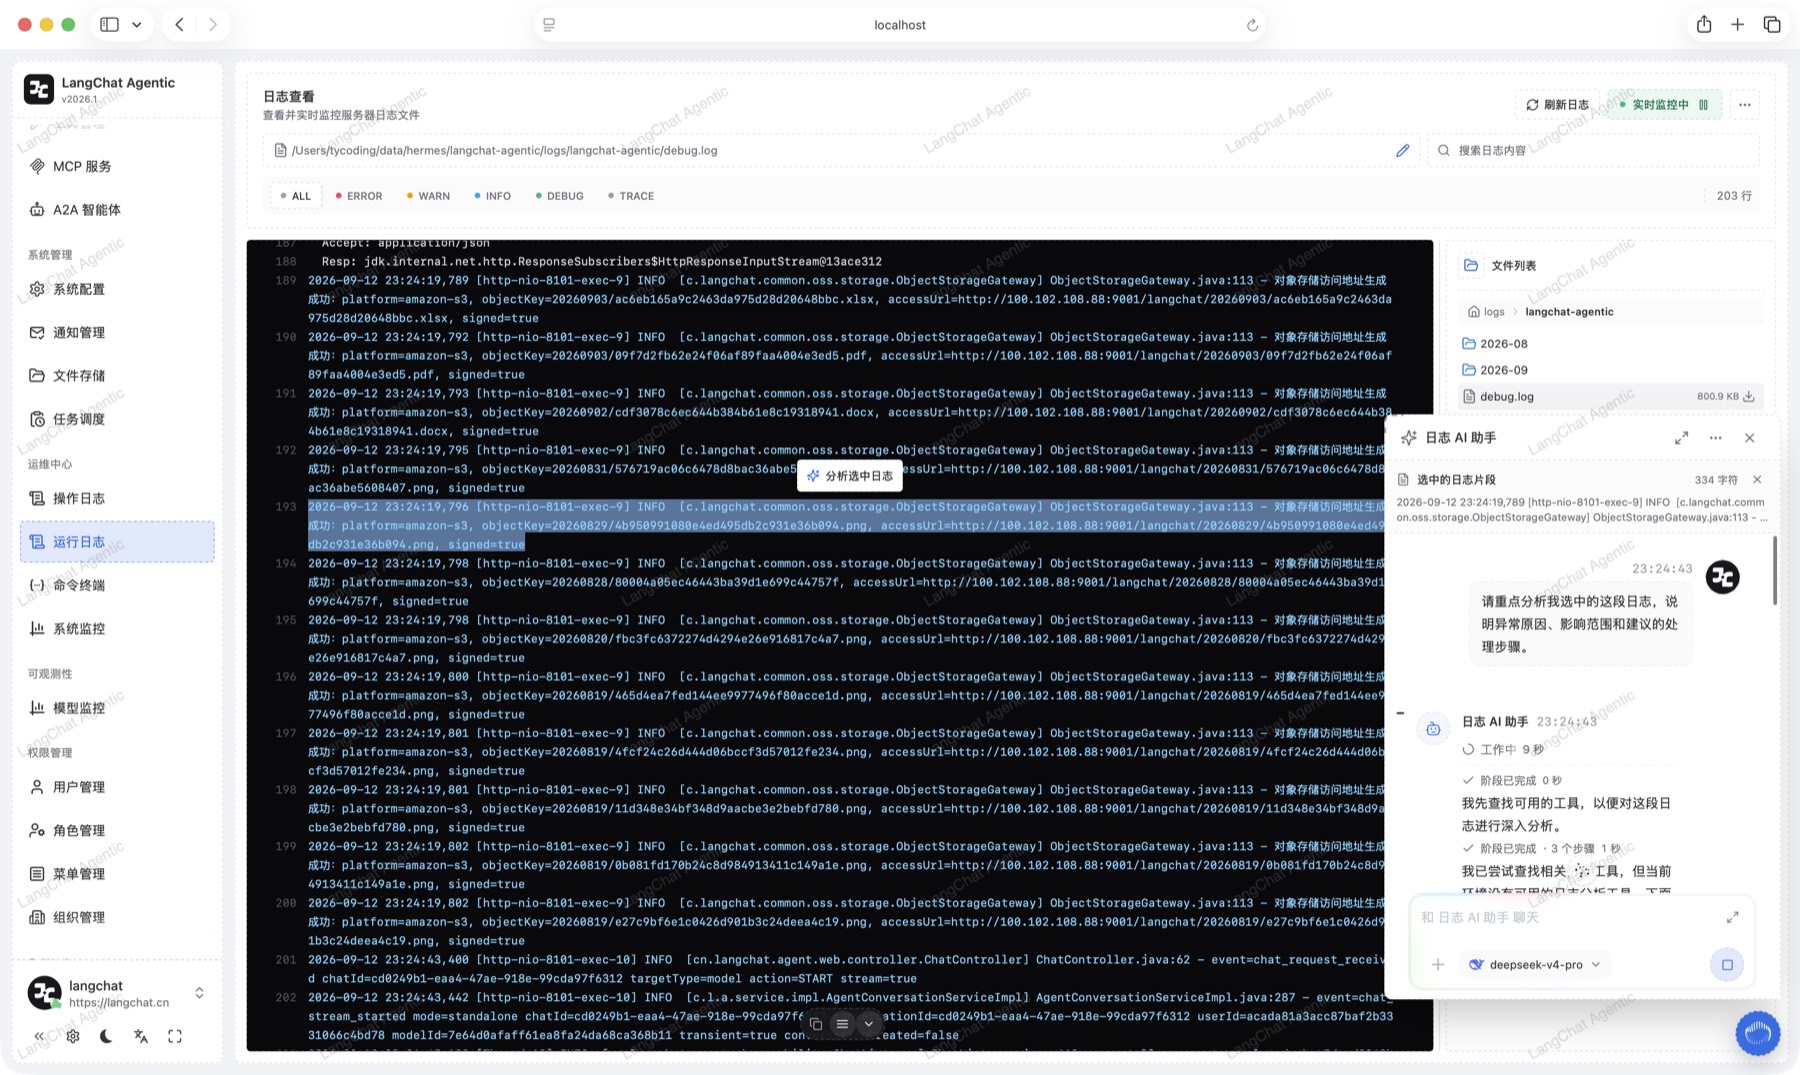
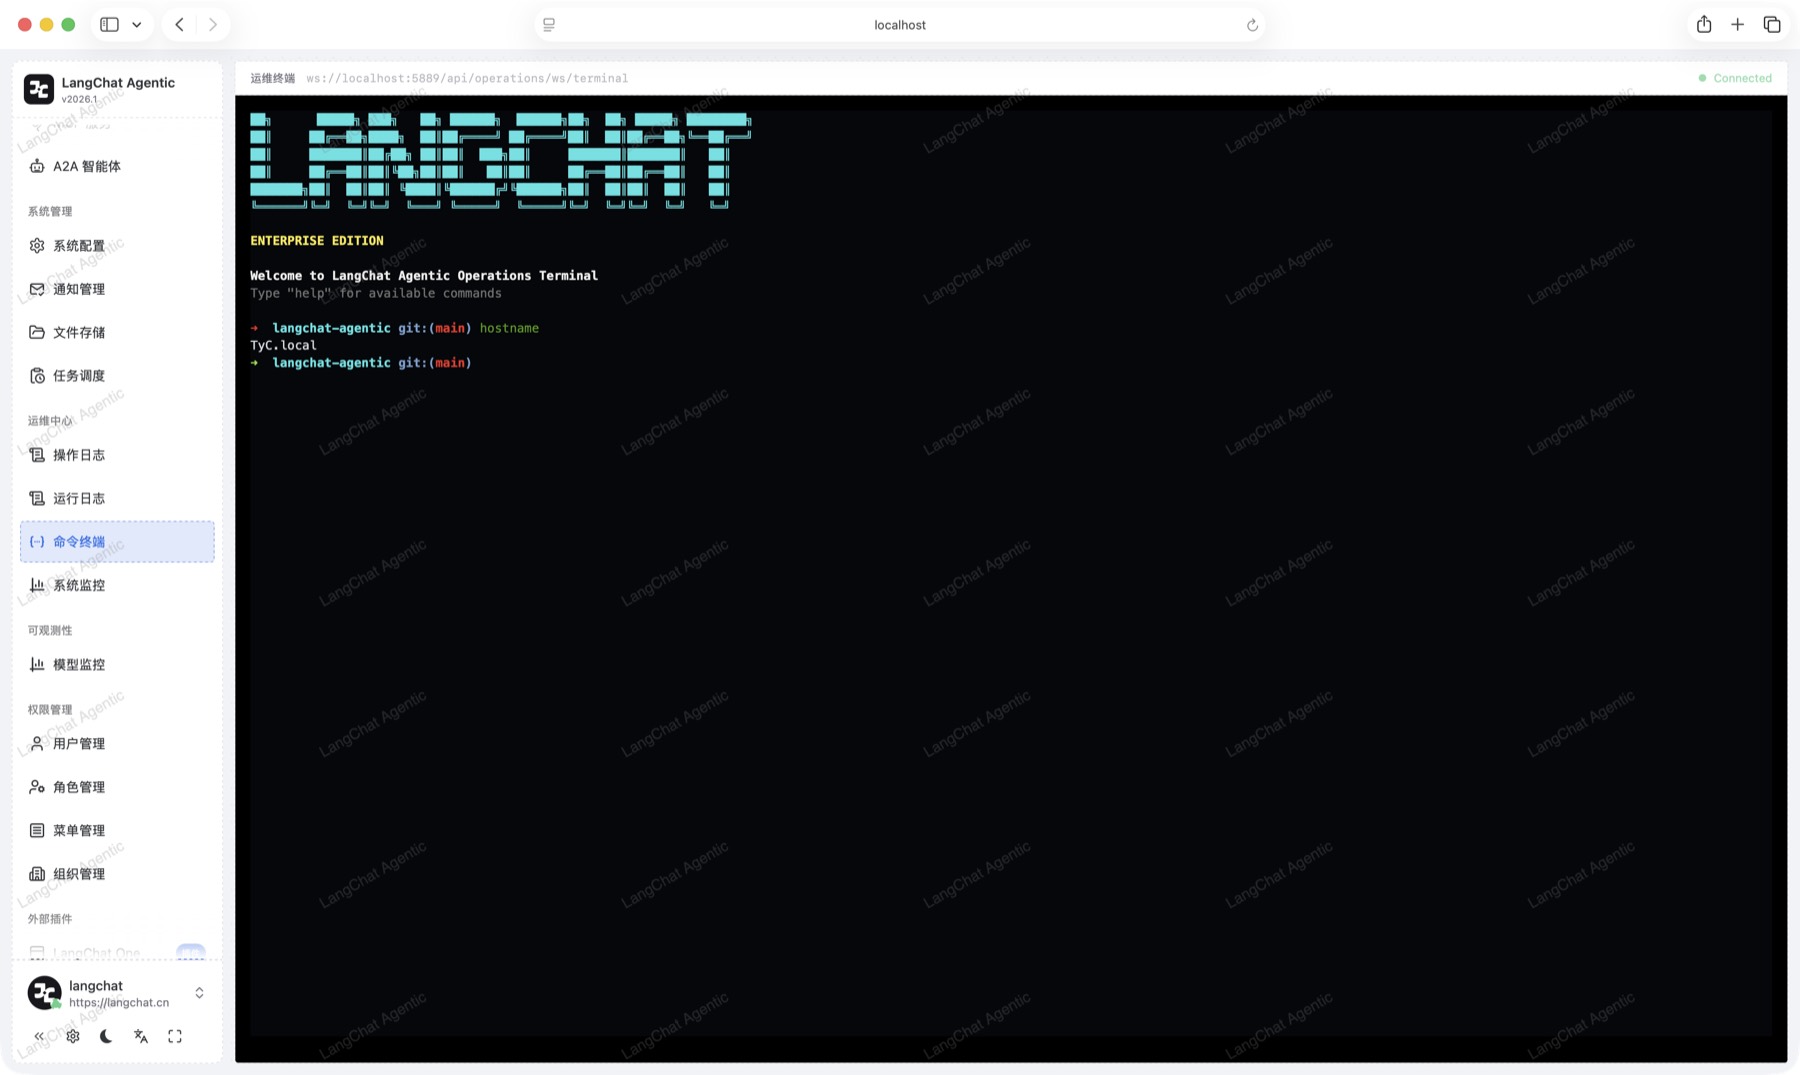
运维中心提供操作日志统计、运行日志与命令终端。运行日志支持 AI 分析,帮助快速定位异常原因;命令终端在受控范围内执行现场诊断命令,避免为了排障而直接登录服务器。
操作日志:接口调用统计与审计
32
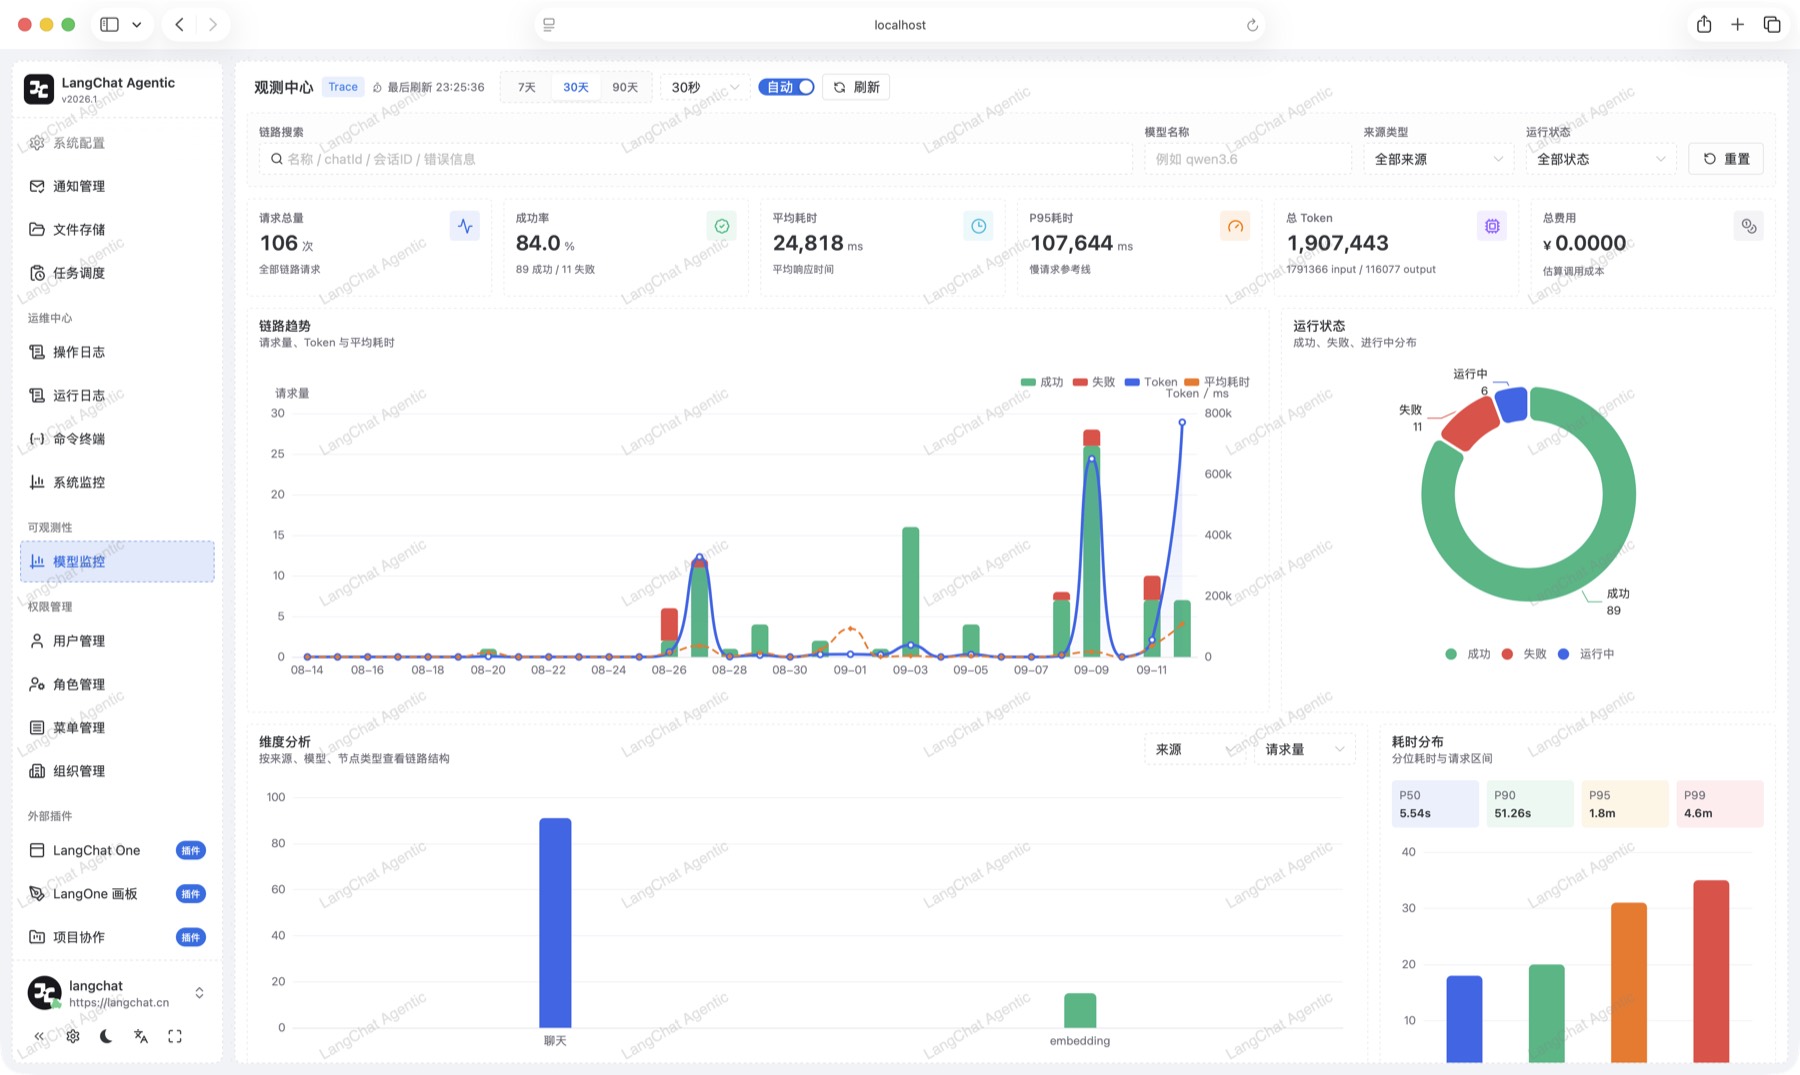
系统监控呈现服务器指标与基础设施健康度,模型监控则衡量 AI 服务的运行质量,包括调用量、响应与异常情况。两者结合,让运维团队既能看到基础设施状态,也能判断模型服务是否稳定可用。
系统监控:服务器指标与运行健康度
33
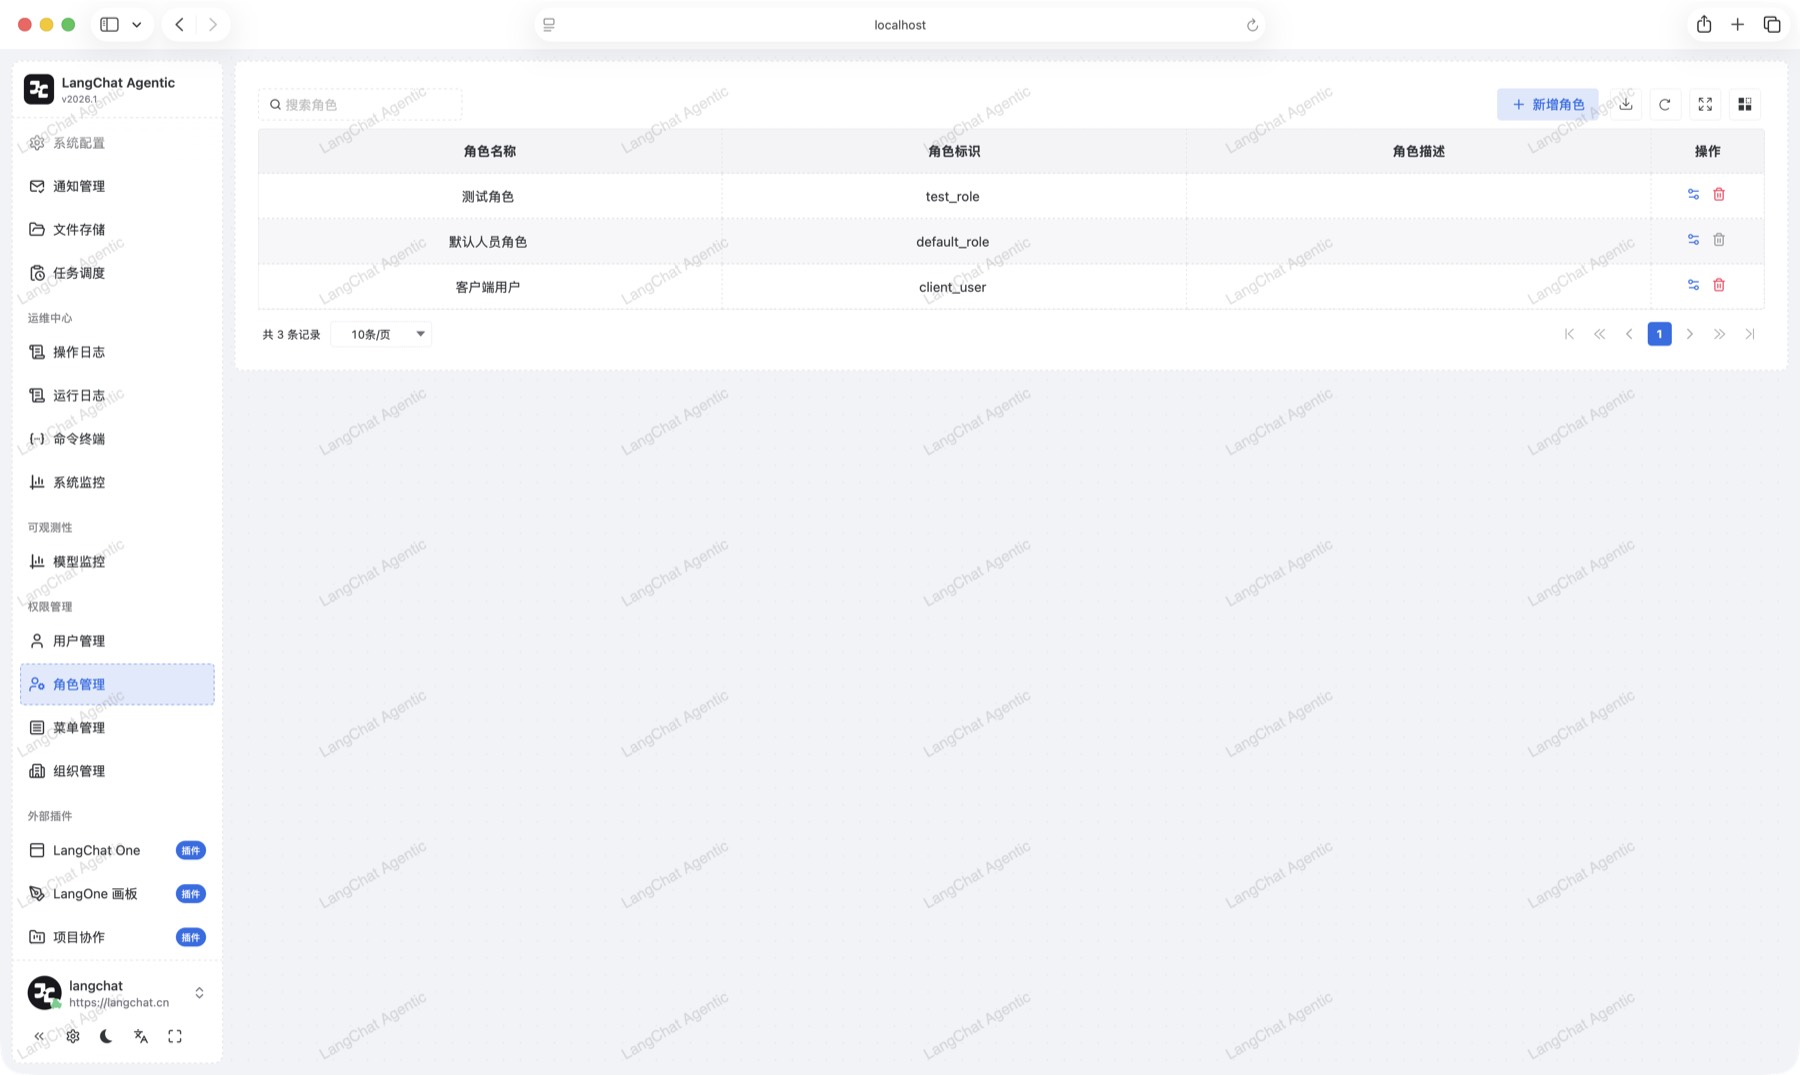
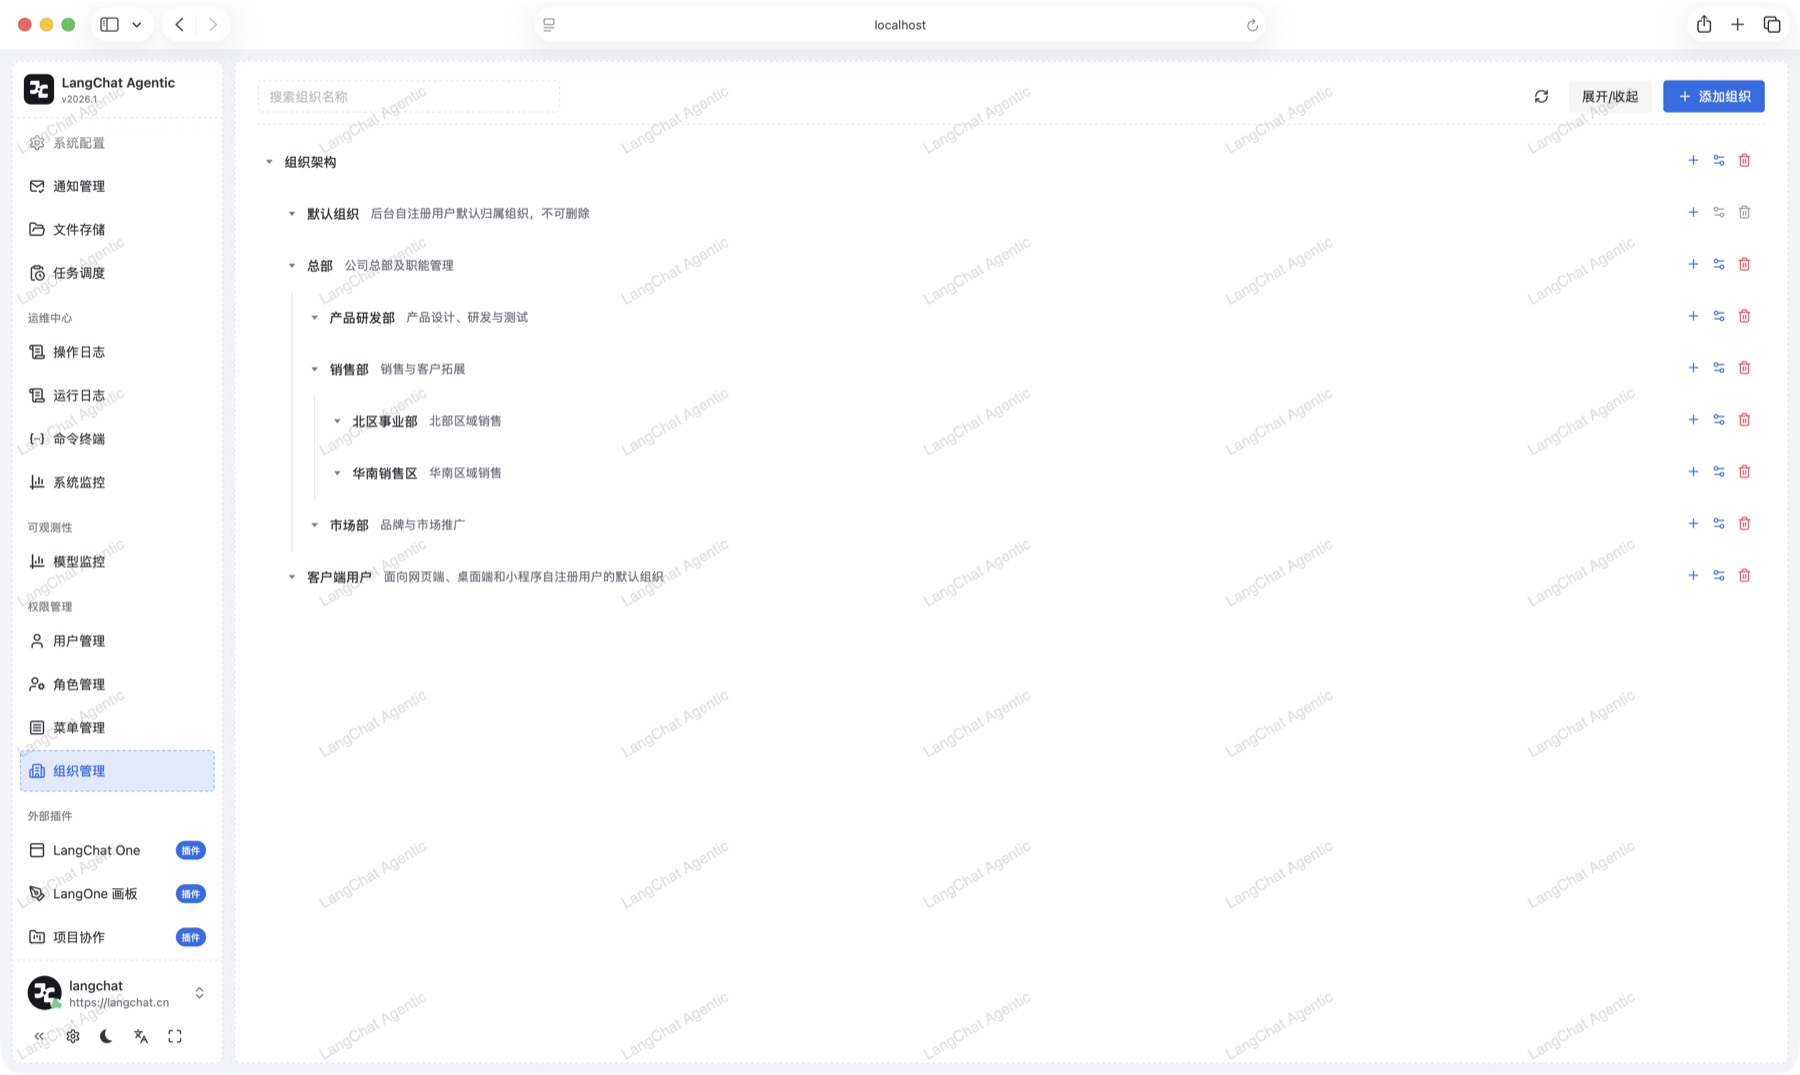
用户管理维护权限主体,角色管理把可复用的授权模板沉淀下来,组织管理则支撑多部门的分层与隔离运营。三者共同构成平台权限体系的组织基础,让应用和知识资产可以按组织结构授权。
用户管理:权限主体入口
34
菜单管理维护平台的导航与功能入口,把菜单、权限与角色关联起来,决定不同角色在平台中可以看到和操作的功能范围,使界面与授权保持一致。
35
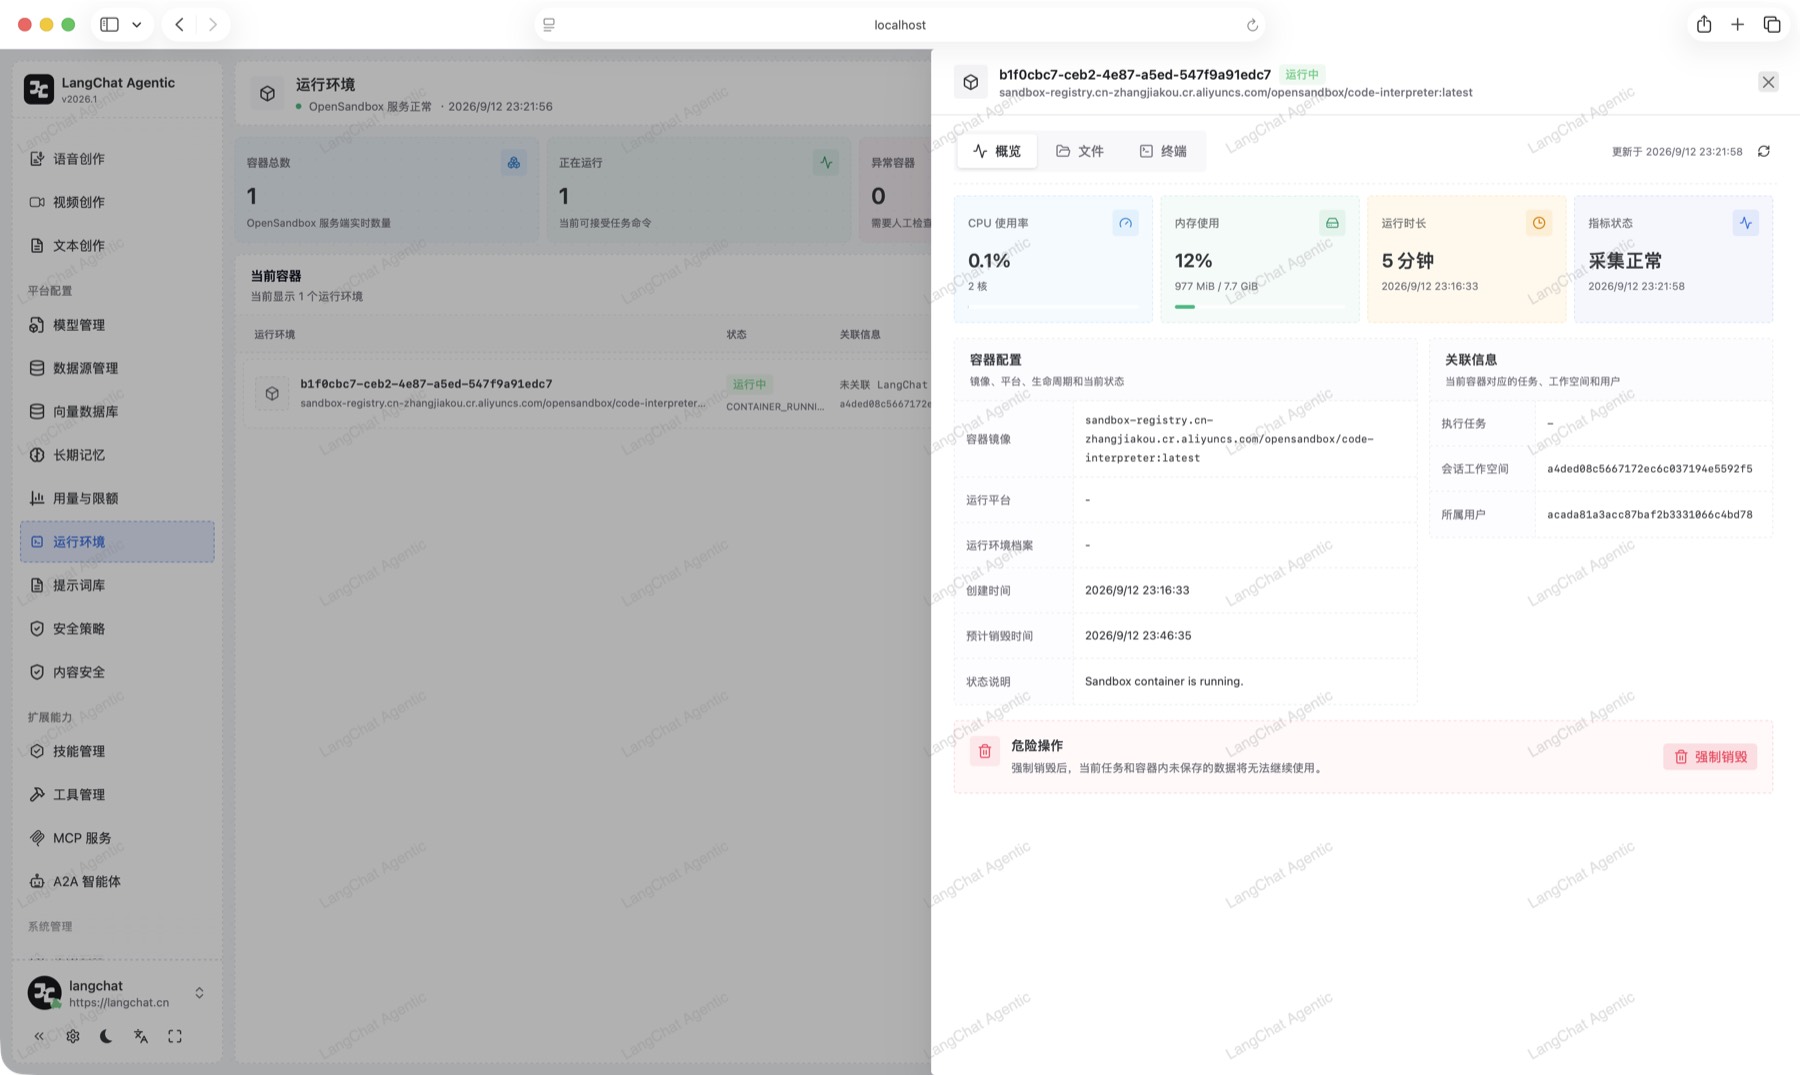
工作空间为每个会话提供隔离的执行环境,管理输入资料、临时文件与最终产物,并呈现磁盘占用、任务与沙箱生命周期;沙箱支持容器监控与终端控制,让代码执行和文件操作在受控环境中完成,降低数据串用与越权风险。
工作空间:会话隔离、磁盘监控与运行诊断
36
平台基于 Java 跨平台特性构建,已完成麒麟 V11 与 V10 的端到端部署验证,同时支持 ARM64 与 x86_64 双架构,一套交付物可在国产环境中直接运行,产品能力与通用环境完全一致。
操作系统
麒麟 Kylin V11 与 V10 已实测验证,兼容 openEuler 系及其他国产 Linux
处理器架构
ARM64(鲲鹏、飞腾)与 x86_64(Intel、AMD、海光)双重支持
数据库
MySQL、PostgreSQL,以及高斯 GaussDB、达梦等国产数据库
本地大模型
Ollama、vLLM、Xinference 私有化部署,数据不出内网
沙箱运行时
OpenSandbox Server 容器化部署,需 Docker 24+
信创环境的完整部署流程、实测验证结果与环境截图,见平台信创适配专页(/xinchuang)。
37
LangChat Agentic 不只是聊天界面。平台把 AI 能力、业务数据、知识资产、内容生产与平台治理统一为可配置、可发布、可追溯、可运营的产品体系,帮助企业形成一套能够建设、发布、使用、审计和持续改进的 AI 应用资产。